Webhook ou interrogation périodique : quelle méthode choisir pour synchroniser vos outils ?
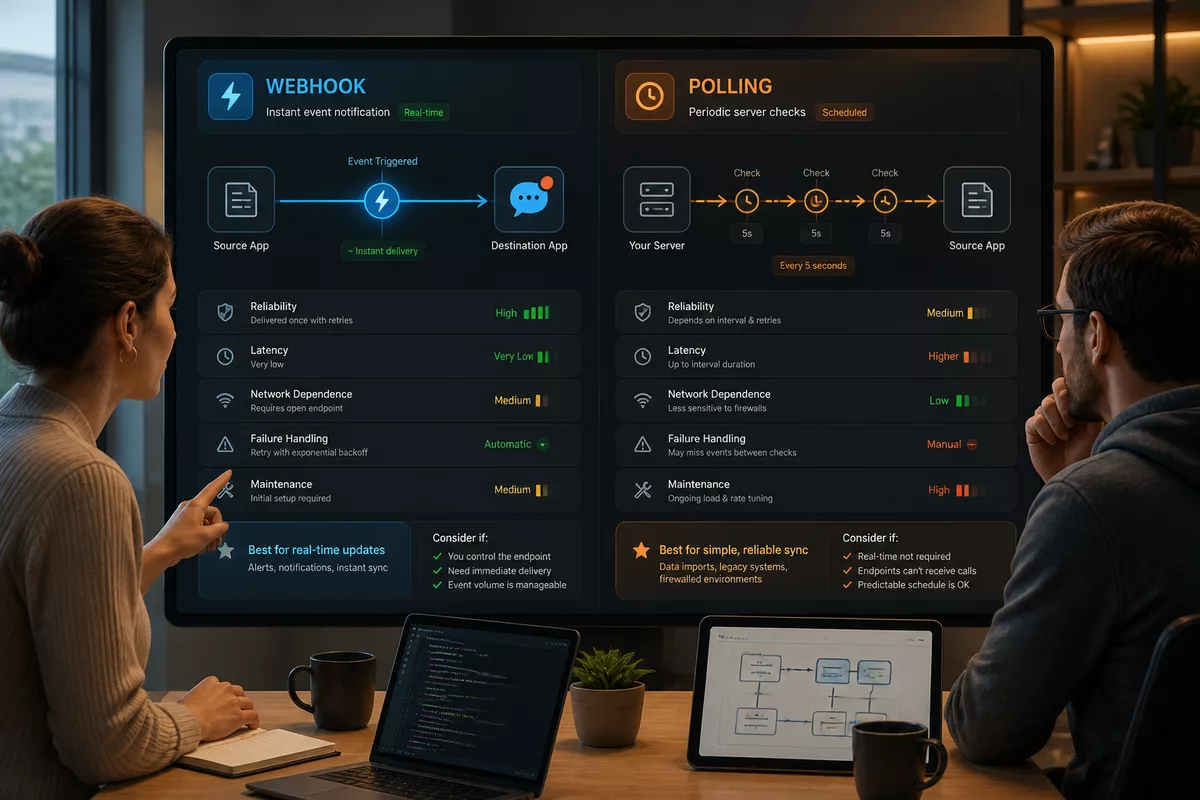
Quand on parle de webhook ou interrogation périodique, la vraie question n’est pas “quelle technique est la plus moderne ?”, mais “quelle architecture tient la charge, les erreurs réseau et la maintenance dans le temps ?”. Le webhook pousse un événement dès qu’il existe. L’interrogation périodique vient vérifier l’état à intervalle fixe. Les deux font le job, mais pas avec la même latence, ni la même fiabilité opérationnelle.
Pour synchroniser un CRM, une boutique en ligne, un outil de support ou un stock, le bon choix dépend surtout de la criticité métier, de la fréquence des changements et de votre capacité à surveiller les échecs. Cet article tranche sans fantasme : quand privilégier la réactivité, quand accepter un léger retard, et comment éviter les doublons, les pertes silencieuses et la surcharge technique.
En bref
🔎 Le webhook convient quand la donnée doit circuler vite et qu’un point de réception fiable est disponible.
⏱️ L’interrogation périodique reste plus simple à déployer, surtout si la réactivité n’est pas critique.
🧩 Le vrai sujet n’est pas la théorie, mais la reprise sur erreur, l’idempotence et la supervision.
⚙️ Dans beaucoup de cas, le meilleur choix est hybride : événement principal + contrôle périodique de rattrapage.
Webhook ou interrogation périodique : comment choisir la méthode la plus fiable ?
La réponse courte est simple : choisissez le webhook si la mise à jour doit être rapide et si vous pouvez sécuriser le point de réception ; choisissez l’interrogation périodique si vous voulez une mécanique plus lisible, plus prévisible et plus facile à contrôler. La méthode la plus fiable n’est pas celle qui promet “le temps réel”, mais celle qui échoue proprement.
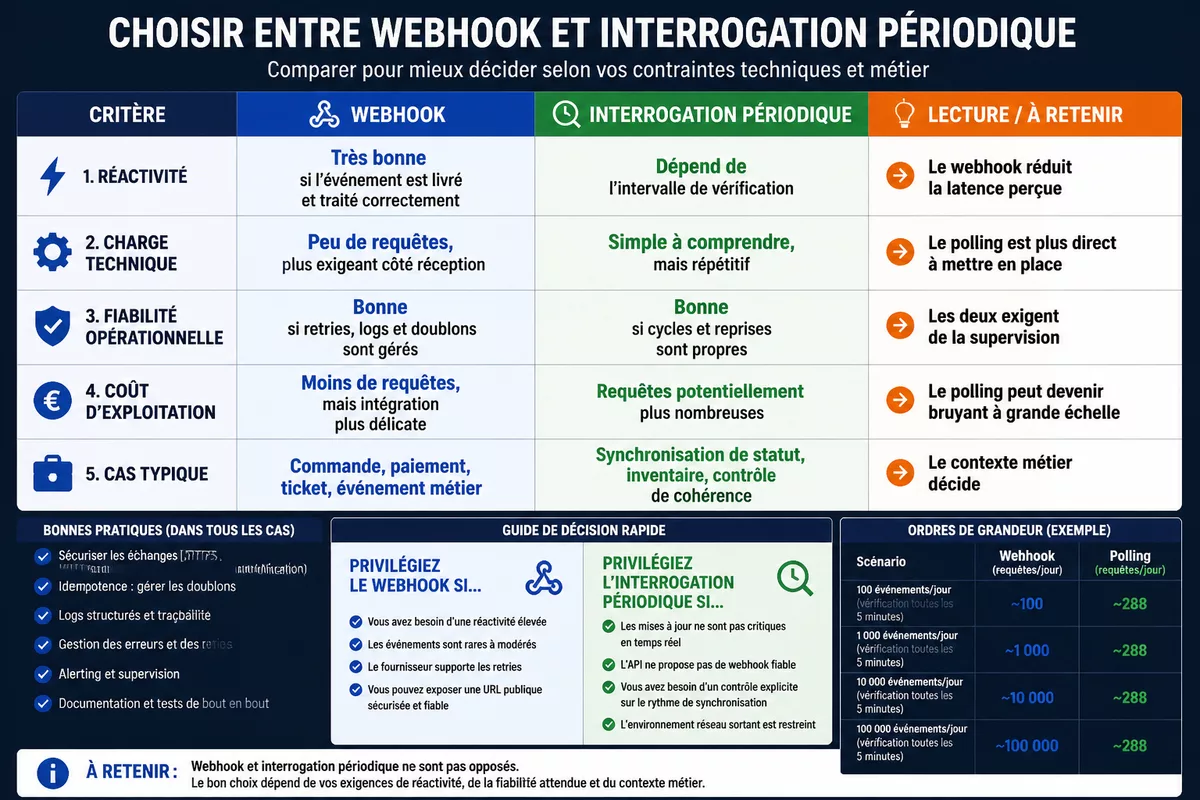
Dans une intégration entre applications, le bon arbitrage se joue entre trois variables : latence acceptable, coût de maintenance et capacité à détecter les écarts. Un webhook bien conçu peut être excellent. Un polling mal calibré peut coûter cher en requêtes et en retard de synchronisation. Le tableau de décision compte plus que le réflexe technique.
| Critère | Webhook | Interrogation périodique | Lecture pratique |
|---|---|---|---|
| Réactivité | Très bonne si l’événement est envoyé correctement | Liée à l’intervalle de vérification | Le webhook réduit la latence perçue |
| Charge technique | Faible côté requêtes, plus exigeant côté réception | Plus simple à comprendre, mais répétitif | Le polling est souvent plus direct à mettre en place |
| Fiabilité opérationnelle | Bonne si les retries, logs et doublons sont gérés | Bonne si les cycles et les reprises sont propres | Les deux exigent de la supervision |
| Coût d’exploitation | Moins de requêtes, mais plus de soin à l’intégration | Coût de requêtes potentiellement plus élevé | Le polling peut devenir bruyant à grande échelle |
| Cas typique | Commande, paiement, ticket, événement métier | Synchronisation de statut, inventaire, contrôle de cohérence | Le contexte métier décide |
La bonne synchronisation n’est pas celle qui va le plus vite, mais celle qui supporte les erreurs sans dériver.
Comprendre les deux mécanismes sans jargon inutile
Le point de départ est très simple. En webhook, la source de l’information prévient votre système quand quelque chose change. En interrogation périodique, votre système demande régulièrement : “y a-t-il du neuf ?”. Le premier modèle est orienté événement ; le second repose sur un contrôle récurrent. Dans les deux cas, la valeur vient de la manière dont vous gérez l’échec, pas du nom de la méthode.
Cette différence de mécanisme a des conséquences très concrètes. Le webhook peut réduire les délais de synchronisation et les appels inutiles. Le polling, lui, permet de garder la main sur le rythme de vérification, ce qui est utile quand la source ne sait pas notifier proprement, quand les restrictions réseau sont fortes ou quand l’intégration doit rester très prévisible.
- Webhook : déclenchement par événement, utile pour les flux urgents ou sensibles au délai.
- Interrogation périodique : vérification à intervalle fixe, utile pour les états changeants mais non critiques.
- Architecture orientée événements : logique plus propre si plusieurs outils doivent réagir au même signal.
- Contrôle périodique : utile comme garde-fou pour détecter les écarts ou les messages perdus.
Pourquoi le webhook séduit quand la réactivité compte
Le webhook est souvent le meilleur choix quand l’utilisateur attend une mise à jour rapide : commande confirmée, ticket ouvert, paiement validé, stock modifié, dossier transmis. Il limite les requêtes répétées et rapproche la synchronisation du temps réel. Dans une chaîne d’intégration bien tenue, il réduit la latence perçue et évite de solliciter inutilement les API.
Mais le webhook ne tient ses promesses que si le point de réception est fiable. Il faut prévoir la validation des messages, la signature quand elle existe, les retries, la gestion des doublons et le traitement idempotent des événements. Sans cela, on gagne de la vitesse au prix d’un flou opérationnel.
Un webhook sans reprise sur erreur n’est pas une optimisation : c’est un point de fragilité.
- Bon cas d’usage : données métier urgentes ou à fort impact utilisateur.
- Bon signal technique : source capable de notifier, cible capable de recevoir proprement.
- Point de vigilance : doublons, délais de livraison, erreurs silencieuses, sécurité du endpoint.
- Bon réflexe : journaliser chaque événement reçu et chaque échec de traitement.
Pourquoi l’interrogation périodique reste souvent indispensable
L’interrogation périodique garde un vrai intérêt parce qu’elle est lisible, robuste et facile à expliquer. On sait quand le système demande la donnée, on sait quoi comparer, et on sait où chercher quand quelque chose manque. Pour une petite équipe ou un contexte où la mise en œuvre doit rester simple, ce modèle reste rassurant.
Elle devient aussi utile comme filet de sécurité. Si un webhook n’arrive pas, si une fenêtre réseau saute ou si un message est rejeté, le polling peut servir de mécanisme de réconciliation. C’est particulièrement pertinent pour les synchronisations d’état, les inventaires et les systèmes où un léger retard est acceptable mais où l’écart final ne doit pas persister.
Exemple simplifié : si un stock change fréquemment et que vous interrogez toutes les dix minutes, votre retard maximal théorique approche dix minutes. Si vous passez à une vérification toutes les minutes, vous réduisez le retard, mais vous multipliez la charge de requêtes. Ce n’est pas un détail : à grande échelle, c’est un coût d’exploitation.
- Définir la fréquence de vérification acceptable pour le métier.
- Mesurer le volume de requêtes généré sur une journée ou une semaine.
- Vérifier les quotas, les limites de débit et les risques de surcharge.
- Prévoir une logique de reprise si la dernière synchronisation remonte trop loin.
Quels critères doivent vraiment guider la décision ?
La bonne réponse ne vient pas d’un goût personnel pour le “temps réel”. Elle dépend de la fréquence des changements, de la tolérance à la latence, de la qualité des API, des contraintes réseau et du niveau de supervision disponible. Si vous devez arbitrer vite, commencez par la criticité métier : que se passe-t-il si l’information arrive avec quelques minutes de retard ?
Le bon choix est rarement un absolu. Un CRM peut accepter un délai de synchronisation sur les fiches enrichies, mais pas sur un changement d’état de commande. Un outil de support peut se contenter d’un contrôle périodique pour certaines métadonnées, alors qu’un paiement ou une alerte de sécurité réclame un déclenchement événementiel. Le métier fixe la priorité, l’architecture suit.
| Situation | Risque principal | Méthode souvent la plus adaptée | Pourquoi |
|---|---|---|---|
| Commande ou paiement | Retard visible par l’utilisateur | Webhook | La mise à jour doit circuler vite |
| Synchronisation d’inventaire | Dérive entre deux systèmes | Hybride | Événement principal + contrôle périodique |
| Statut peu critique | Coût inutile de requêtes répétées | Interrogation périodique | La simplicité prime sur la fraîcheur immédiate |
| API avec contraintes réseau | Perte de messages ou réception instable | Interrogation périodique | Le modèle “pull” reste plus tolérant |
Il faut aussi regarder la manière dont vous traitez les incidents. Une synchronisation fiable ne se limite pas au transport du message. Elle inclut les journaux, les alertes, les essais de reprise, les files d’attente quand le traitement est asynchrone et une règle claire pour dire quand un événement est considéré comme “absorbé”. Sans ces garde-fous, la méthode choisie compte moins que son exploitation.
- Criticité : plus l’action métier est urgente, plus le webhook gagne du terrain.
- Volume : plus le nombre d’événements est élevé, plus l’interrogation répétée peut devenir coûteuse.
- Supervision : sans alertes ni journaux, aucune méthode n’est vraiment fiable.
- Contraintes réseau : certaines architectures acceptent mieux le modèle “pull” que le “push”.
- Équipes : une petite équipe peut préférer une solution plus simple à diagnostiquer.
La technique la plus élégante n’est pas toujours la plus maintenable. Le vrai coût se voit quand l’incident arrive.
Peut-on combiner webhook et interrogation périodique ?
Oui, et c’est souvent le scénario le plus sain. Le webhook sert de canal principal pour accélérer la propagation des changements, tandis que l’interrogation périodique joue le rôle de rattrapage et de contrôle de cohérence. Cette combinaison réduit le risque de perte silencieuse sans imposer une logique complexe à chaque traitement.
Dans une synchronisation d’outils, l’approche hybride est particulièrement utile si votre architecture comporte plusieurs points faibles : fournisseur externe peu stable, réseau intermittent, quotas serrés, ou équipe d’exploitation réduite. Le contrôle périodique permet alors de vérifier que l’état réel et l’état répliqué ne divergent pas trop longtemps.
La clé, ici, est d’éviter la double écriture sauvage. Si le webhook et le polling peuvent tous deux déclencher la même action, il faut un identifiant d’événement, une logique d’idempotence et un statut de traitement partagé. Sinon, vous créez des doublons au lieu de résoudre les pertes.
- Définir un canal principal et un canal de secours.
- Associer un identifiant unique à chaque événement traité.
- Journaliser l’arrivée, la validation et l’exécution.
- Prévoir un rattrapage périodique sur les écarts détectés.
Erreurs fréquentes dans la synchronisation d’outils
La plupart des incidents ne viennent pas du choix initial, mais de l’absence de discipline d’exploitation. Le premier piège consiste à oublier que les événements peuvent arriver en double, en retard ou dans le désordre. Le second consiste à confondre “reçu” et “traité” : un message reçu par votre endpoint n’est pas encore une synchronisation réussie.
Autre erreur classique : choisir une méthode sans tester la reprise. Un webhook doit être capable de rejouer proprement un événement. Un polling doit être capable de reprendre au bon curseur sans écraser les changements intermédiaires. Si vous ne testez pas les échecs, vous ne testez pas la synchronisation ; vous testez seulement le chemin heureux.
Enfin, il ne faut pas sous-estimer la supervision. Sans alertes, le système peut dériver pendant des heures avant qu’un humain ne remarque un écart de stock, un ticket manquant ou une commande non répercutée. Une synchronisation fiable est visible : elle laisse des traces, des métriques et des seuils d’alerte.
Sources utiles à consulter
Pour sécuriser le choix, il vaut mieux repartir des documents qui font autorité sur votre intégration plutôt que d’improviser une règle générique.
- Documentation officielle de l’API source : comportements des webhooks, délais, retries, signatures, quotas.
- Documentation officielle de l’API cible : limites de débit, format attendu, gestion des doublons, erreurs de validation.
- Guides de sécurité des API : validation des appels entrants, authentification, contrôle d’intégrité, journalisation.
- Documentation de la plateforme d’intégration : files d’attente, reprises, alertes, surveillance et anti-doublons.
À retenir
- ⚡ Le webhook est prioritaire quand la réactivité métier compte vraiment.
- 🧱 L’interrogation périodique reste utile quand la simplicité et la prévisibilité priment.
- 🛡️ La fiabilité dépend surtout de l’idempotence, des retries et de la supervision.
- 🔁 Le modèle hybride évite souvent les pertes silencieuses sans alourdir tout le système.
- 📊 Le bon arbitrage se lit dans la latence acceptable, les quotas et le coût d’exploitation.
FAQ
Peut-on se passer totalement de l’interrogation périodique ?
Parfois oui, mais rarement sans risque. Si vos webhooks sont parfaitement reçus, validés et surveillés, ils peuvent couvrir l’essentiel du flux. En pratique, beaucoup d’équipes gardent un contrôle périodique de secours pour détecter les écarts ou récupérer un événement perdu.
Que faire si un webhook n’arrive pas ou arrive en double ?
Il faut prévoir une logique d’idempotence et un identifiant unique par événement. Le traitement doit pouvoir reconnaître un doublon sans réexécuter l’action. Si un message manque, un rattrapage par interrogation périodique ou par file de reprise permet de réconcilier l’état.
Quelle méthode choisir pour une petite équipe ?
Si la réactivité n’est pas critique, l’interrogation périodique est souvent plus facile à maintenir et à diagnostiquer. Si le flux est urgent, le webhook s’impose, mais seulement si vous pouvez gérer les erreurs et les alertes sans multiplier les points de fragilité.
Le webhook est-il toujours plus rapide que l’interrogation périodique ?
En théorie oui, car il réagit à l’événement. En pratique, la vitesse réelle dépend de la qualité de la livraison, de la disponibilité du point de réception et du temps de traitement derrière. Un webhook mal exploité peut devenir plus lent qu’un polling simple mais stable.
Comment éviter les doublons dans une synchronisation hybride ?
Le plus sûr est d’associer un identifiant d’événement, de stocker l’état de traitement et de rendre l’opération idempotente. Ainsi, si le webhook et le polling voient la même mise à jour, le système n’exécute l’action qu’une seule fois.