Observabilité et supervision : la différence qui accélère le diagnostic d’un incident
La vraie observabilité supervision différence tient à la finalité : la supervision dit qu’un problème existe, l’observabilité aide à comprendre pourquoi. Dans un système informatique, cette nuance change la vitesse de réaction dès qu’une alerte tombe, qu’une latence grimpe ou qu’un service sature.
Ce guide pose les définitions sans jargon, compare les signaux utiles — métriques, journaux, traces — puis montre comment les croiser pour diagnostiquer une panne, remonter à la cause racine et corriger sans perdre du temps dans de fausses pistes.
En bref
🧭 La supervision détecte un écart visible : indisponibilité, saturation, seuil franchi. Elle sert d’alarme.
🔎 L’observabilité relie métriques, journaux et traces pour comprendre la cause probable d’un incident.
⚙️ Dans un SI simple, la supervision suffit souvent pour lancer l’enquête ; dans un système distribué, l’observabilité accélère nettement le diagnostic.
🚦 Le meilleur réflexe reste combiné : alerter vite, puis investiguer avec des signaux corrélés au lieu de multiplier les alertes.
Comprendre les deux notions sans confusion
La supervision informatique surveille des indicateurs connus à l’avance pour dire si un service reste dans ses bornes normales. L’observabilité informatique va plus loin : elle permet de déduire l’état interne d’un système à partir de ses sorties. En pratique, la première déclenche l’alerte, la seconde aide à reconstruire la chaîne d’événements.
Ce que recouvre la supervision
La supervision répond à une question simple : est-ce que ça fonctionne encore comme prévu ? Elle s’appuie sur des seuils, des tableaux de bord et des alertes applicatives pour repérer une panne, une saturation ou un dépassement de latence. C’est la couche la plus visible de la surveillance système.
- Disponibilité d’un service, d’une API ou d’un serveur.
- Seuils de CPU, mémoire, disque ou réseau.
- Taux d’erreur et temps de réponse.
- Alerte quand un indicateur sort d’une plage normale.
Ce que recouvre l’observabilité
L’observabilité répond à une autre question : qu’est-ce qui se passe à l’intérieur du système ? Elle s’appuie sur la corrélation des métriques, des journaux et des traces pour relier un symptôme à une cause possible. C’est ce qui accélère l’analyse d’incident quand les symptômes se ressemblent mais que les causes changent.
La supervision ne voit pas tout, mais elle voit vite. L’observabilité voit plus large, mais elle demande des signaux bien instrumentés.
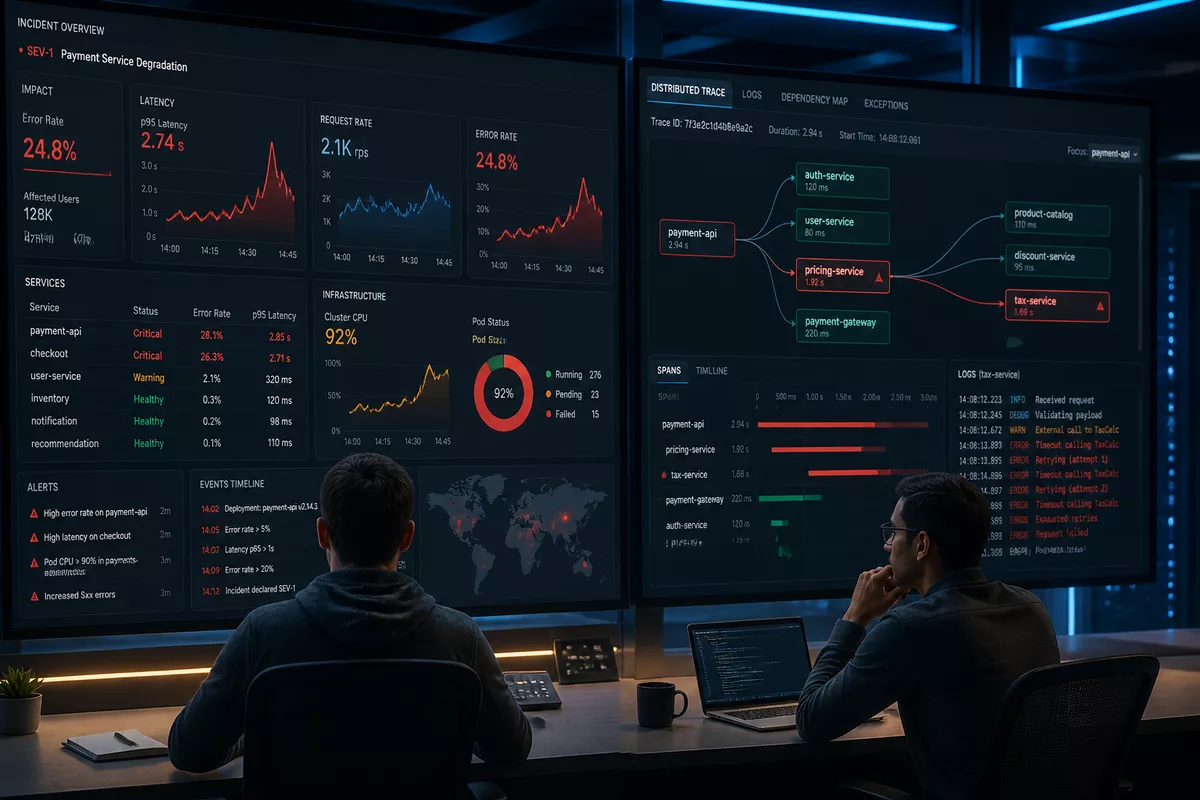
Dans un incident réel, une métrique montre la hausse de latence, les journaux révèlent le message d’erreur et les traces localisent l’appel bloquant. Sans ce trio, on finit souvent par deviner au lieu de diagnostiquer.
Supervision et observabilité : quelle différence concrète au moment d’un incident ?
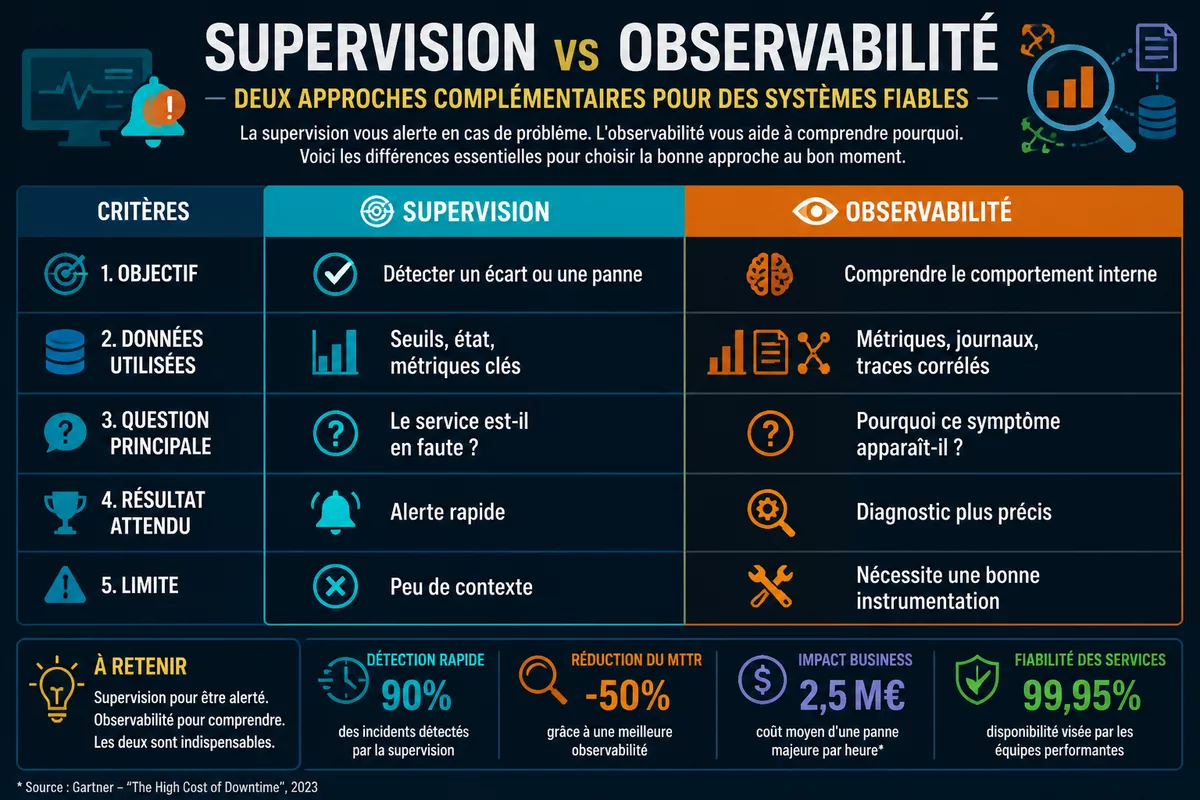
La différence est nette au moment critique : la supervision dit qu’il faut agir, l’observabilité explique où chercher. La première est utile pour détecter rapidement une panne ou une dérive ; la seconde réduit le temps passé à tester des hypothèses au hasard, surtout quand plusieurs briques sont impliquées.
| Critère | Supervision | Observabilité |
|---|---|---|
| Objectif | Détecter un écart ou une panne | Comprendre le comportement interne |
| Données utilisées | Seuils, état, métriques clés | Métriques, journaux, traces corrélés |
| Question principale | Le service est-il en faute ? | Pourquoi ce symptôme apparaît-il ? |
| Résultat attendu | Alerte rapide | Diagnostic plus précis |
| Limite | Peu de contexte | Nécessite une bonne instrumentation |
Un bon tableau de bord n’est pas celui qui montre le plus de choses. C’est celui qui fait gagner le plus de minutes quand l’incident commence.
Sur un site web, cette différence apparaît vite. Si une page ralentit, une alerte de supervision dit qu’il y a un problème ; l’observabilité aide à savoir si la vraie cause vient du code, de la base, du réseau ou d’une dépendance externe. Pour un cas proche, voir aussi temps de chargement d’un site : identifier les freins.
Comment diagnostiquer un incident plus vite ?
Quand l’alerte tombe, l’objectif n’est pas d’accumuler les écrans, mais de suivre un ordre simple : confirmer l’impact, croiser les signaux, isoler le composant puis corriger. C’est là que supervision et observabilité se complètent vraiment : la première ouvre l’enquête, la seconde la ferme.
- Confirmer l’incident : vérifier que l’alerte correspond à un impact réel, pas à un simple pic sans effet utilisateur.
- Croiser les signaux : lire la métrique concernée, ouvrir les journaux utiles et suivre les traces de bout en bout.
- Isoler la cause : repérer le composant en défaut, puis reconstituer la chaîne d’événements avant le symptôme.
- Corriger et prévenir : appliquer le correctif, puis ajuster les seuils ou les alertes pour éviter la répétition.
Exemple fictif mais courant : une API d’authentification répond plus lentement, la supervision déclenche l’alerte, puis les traces montrent qu’un appel vers la base de données attend trop longtemps. Le vrai point de rupture n’était pas l’API, mais une dépendance saturée. Sans les traces, l’enquête dure bien plus longtemps.
Un incident ne se résout pas plus vite parce qu’on a plus d’alertes, mais parce qu’on a les bons signaux, au bon niveau de lecture.
Si le problème touche un hébergement, le même réflexe s’applique : on ne change pas tout à l’aveugle. L’analyse gagne à être croisée avec identifier la vraie cause d’un site lent et avec lire une offre d’hébergement sans se tromper.
Faut-il choisir entre supervision et observabilité ?
Non. Dans la majorité des SI, le bon choix n’est pas l’un ou l’autre, mais un duo bien réglé : la supervision pour détecter rapidement, l’observabilité pour comprendre vite et éviter le bricolage. Le niveau de maturité du système, le nombre de dépendances et la fréquence des incidents dictent surtout la place de chacun.
Dans quels cas la supervision suffit presque
La supervision peut suffire quand le système est simple, les seuils sont stables et les défaillances attendues sont connues à l’avance. C’est le cas d’une application peu distribuée, d’un serveur isolé ou d’une infrastructure où l’on veut surtout savoir si une ressource sort de sa plage normale.
- Architecture peu complexe.
- Quelques indicateurs suffisent pour décider.
- Les incidents sont faciles à reproduire.
- Le besoin principal est l’alerte, pas l’analyse profonde.
Dans quels cas l’observabilité devient indispensable
L’observabilité devient utile dès qu’un incident traverse plusieurs briques, plusieurs équipes ou plusieurs couches techniques. Dans un environnement cloud, un microservice lent peut être la conséquence d’une base de données, d’un cache, d’un réseau ou d’un appel externe. La simple supervision ne dit pas où regarder ; l’observabilité réduit cette zone d’ombre.
- Architecture distribuée ou microservices.
- Incidents intermittents ou difficiles à reproduire.
- Besoins forts de corrélation entre couches.
- Recherche rapide de cause racine après une panne.
Pour lire un environnement qui grandit sans confondre confort et visibilité, l’arbitrage est proche de celui décrit dans VPS managé ou serveur dédié. On choisit surtout selon la charge, les dépendances et le niveau de contrôle voulu.
Comment réduire le bruit d’alertes sans perdre en visibilité ?
Il faut alerter sur ce qui dégrade réellement le service, pas sur chaque variation sans impact. Une supervision utile filtre le bruit, agrège les doublons et laisse apparaître le signal utile ; une observabilité bien instrumentée évite de transformer chaque symptôme en incident prioritaire. Sinon, on perd du temps et on fatigue les équipes.
- Regrouper les alertes qui décrivent le même incident.
- Privilégier les alertes liées à l’impact utilisateur ou au SLO.
- Attribuer un propriétaire clair à chaque signal critique.
- Revoir les seuils après chaque incident majeur.
- Conserver les journaux utiles, pas les logs qui noient le diagnostic.
Quand la continuité de service est en jeu, le raisonnement est proche de celui qu’on applique à la sauvegarde et à la résilience. Voir aussi réduire les interruptions sans sous-estimer les risques.
Sources utiles à consulter
- AWS — Différence entre monitoring et observability : bon cadrage pour distinguer détection et compréhension.
- IBM — Qu’est-ce que l’observabilité ? : une définition stable et utile pour les bases.
- OpenTelemetry — Documentation officielle : utile pour la collecte de métriques, journaux et traces.
- Centreon — Observabilité vs supervision : intéressant pour relier théorie et exploitation.
À retenir
- 🧭 La supervision détecte vite ; l’observabilité explique mieux.
- 🔎 Les métriques, journaux et traces prennent tout leur sens ensemble.
- ⚙️ Plus le système est distribué, plus l’observabilité devient décisive.
- 🚦 Réduire le bruit d’alertes accélère vraiment le diagnostic.
- 🛠️ Le bon réflexe reste : alerter, corréler, isoler, corriger.
FAQ
La supervision remplace-t-elle l’observabilité ?
Non. La supervision détecte qu’un problème existe, tandis que l’observabilité aide à comprendre pourquoi. Sur un SI simple, la supervision peut suffire pour alerter, mais elle ne remplace pas la lecture croisée des signaux quand l’incident devient complexe.
Les journaux suffisent-ils pour diagnostiquer un incident ?
Pas vraiment. Les journaux sont précieux, mais ils prennent tout leur sens quand ils sont croisés avec les métriques et les traces. Seuls, ils donnent souvent un indice partiel, pas toujours la cause complète ni l’ordre exact des événements.
Quel est le meilleur point de départ pendant une panne ?
Le plus efficace est de confirmer l’impact utilisateur, puis de regarder la métrique la plus proche du symptôme. Ensuite, il faut ouvrir les journaux pertinents et remonter aux traces. Cet ordre évite de partir trop tôt dans une hypothèse secondaire.
Comment réduire le temps de recherche de la cause racine ?
En préparant la corrélation avant l’incident : bons seuils, bons identifiants de service, journaux exploitables et traces bien reliées. Plus l’instrumentation est propre, plus l’enquête est courte. Le gain vient moins du volume de données que de leur lisibilité.