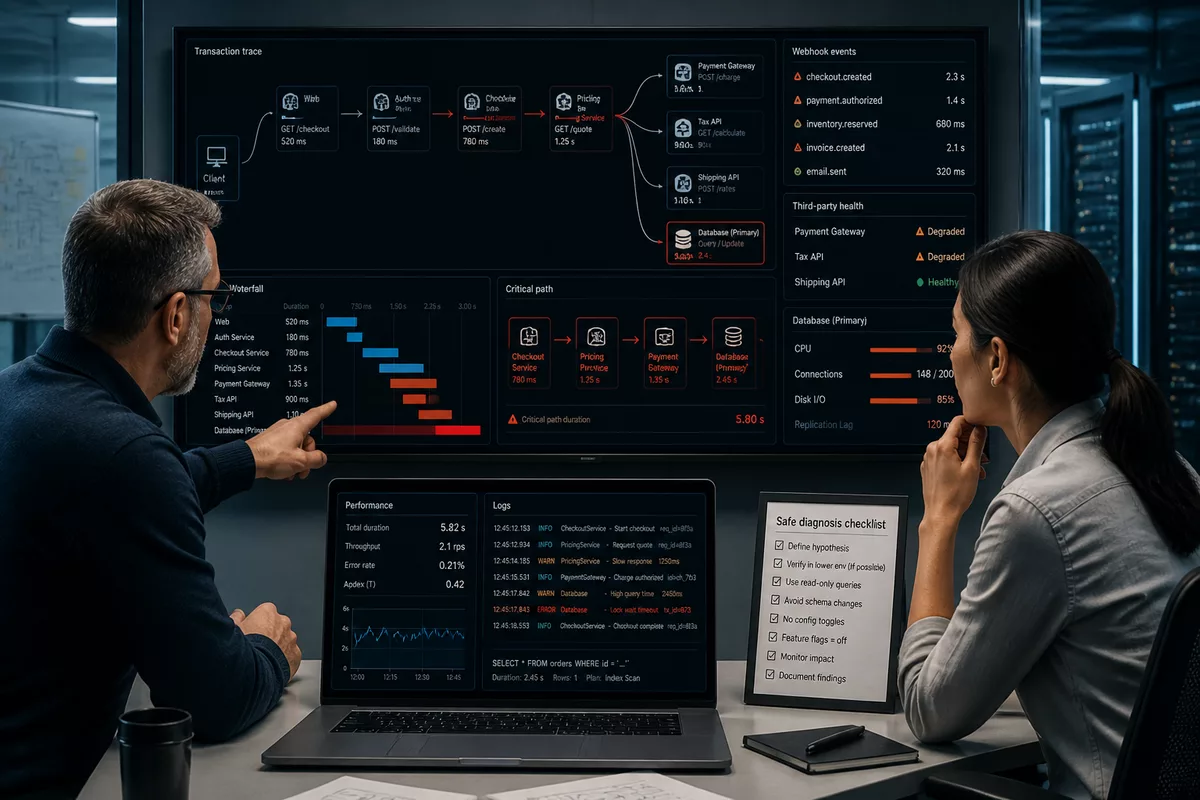
SaaS qui ralentit après plusieurs intégrations : diagnostiquer les causes et agir vite
Un SaaS qui ralentit après intégrations n’est pas seulement “un produit devenu lourd”. Le plus souvent, la lenteur vient d’un chemin critique qui attend trop longtemps : appels externes en chaîne, traitement synchrone trop chargé, base de données sous pression, webhooks mal gérés ou dépendances tierces plus lentes que prévu.
L’enjeu n’est pas de deviner la bonne cause, mais d’isoler rapidement le bon niveau de panne. Dans cet article, on part du symptôme visible, on le relie aux métriques utiles, puis on passe aux tests simples qui permettent de décider quoi corriger en premier, sans casser la production.
En bref
⚡ Un ralentissement après plusieurs intégrations tierces vient souvent d’un temps de réponse allongé, pas d’un seul bug isolé.
🧪 Le bon réflexe consiste à tester un seul axe à la fois : API, webhooks, base de données, files d’attente ou mise en cache.
📉 Si la lenteur touche seulement certaines actions, le problème est souvent dans le parcours fonctionnel, pas dans tout le SaaS.
🎯 Le diagnostic utile vise un résultat simple : savoir quoi désactiver, quoi mesurer, puis quoi corriger en premier.
Comprendre le symptôme avant de chercher la cause
Avant de parler d’architecture, il faut nommer la panne avec précision. Un ralentissement peut être global, intermittent, progressif ou limité à une action précise. Dans un SaaS, cette différence change tout : un chargement lent au premier écran ne se traite pas comme une synchronisation qui s’éternise en arrière-plan.
Regardez d’abord quand la lenteur apparaît : à l’ouverture, à l’enregistrement, lors d’un import, pendant un webhook, ou après une synchronisation massive. C’est ce repérage qui permet d’éviter le faux diagnostic du “tout est lent”, alors qu’un seul parcours critique est touché.
- Lenteur générale : plusieurs écrans ou actions prennent plus de temps que d’habitude.
- Latence intermittente : le produit va bien, puis se fige par moments, souvent sous charge ou à certaines heures.
- Baisse progressive : la performance se dégrade après chaque nouvelle intégration, chaque volume supplémentaire ou chaque montée en charge.
- Lenteur de synchronisation : les traitements secondaires finissent par déborder sur l’expérience utilisateur.
Le bon diagnostic commence quand on mesure ce qui attend réellement une réponse externe, pas seulement ce qui s’affiche à l’écran.
Pourquoi un SaaS ralentit-il après plusieurs intégrations ?
La réponse courte : parce que chaque intégration ajoute des attentes, des conversions de données, des contrôles, parfois des écritures supplémentaires, et souvent un peu de fragilité. Quand plusieurs services tiers s’empilent, le temps de réponse se compose, la marge de sécurité disparaît, et un point faible devient visible pour l’utilisateur.
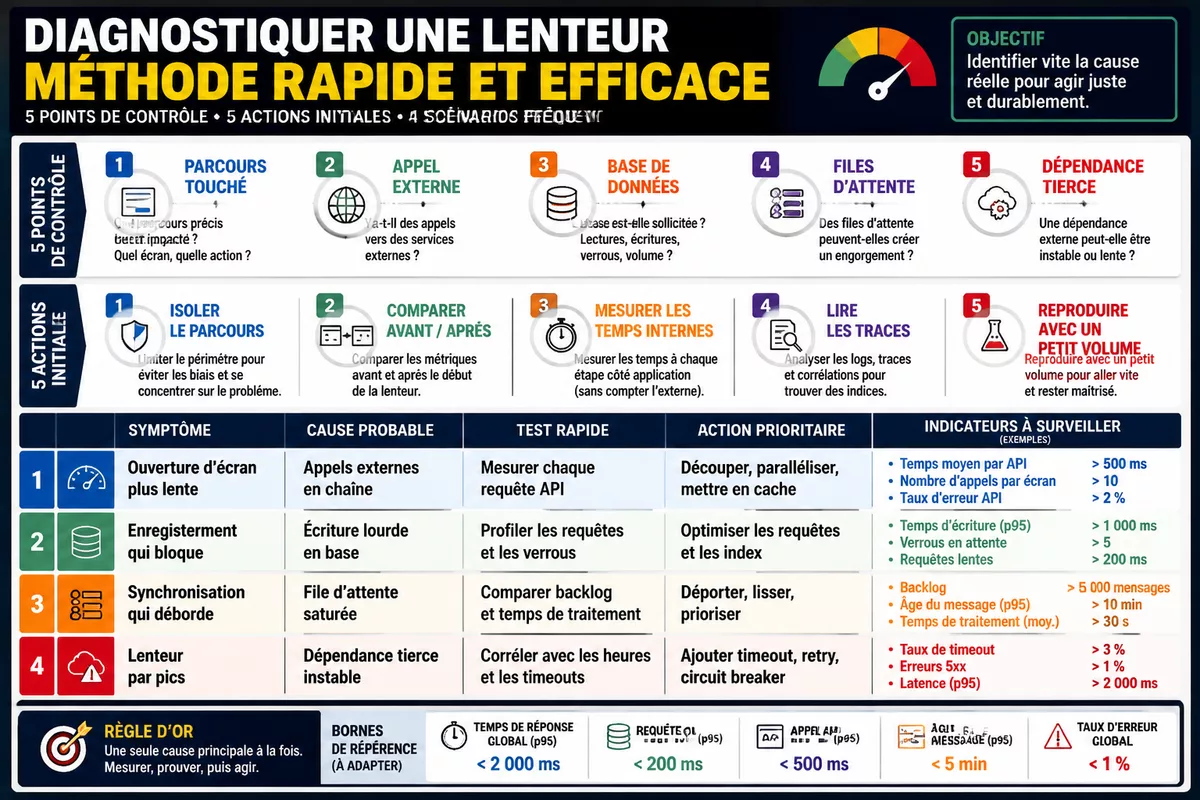
Effet cumulé des appels externes
Chaque appel à une API tierce ajoute un délai possible. Un service lent, un quota proche de la limite, une réponse plus volumineuse que prévu ou un réseau instable suffisent à rallonger la chaîne. Si votre application attend trois services l’un après l’autre, la latence visible ne correspond plus à un seul appel, mais à l’addition de tous les temps morts.
Traitements synchrones trop lourds
Le problème classique : l’application fait trop de choses au moment où l’utilisateur agit. Au lieu de déclencher une tâche secondaire en arrière-plan, elle attend le résultat d’une synchronisation, d’un enrichissement ou d’un calcul annexe. Le serveur reste occupé plus longtemps, l’interface aussi, et la sensation de lenteur grimpe vite.
Pression sur la base de données et les ressources
Les intégrations ne touchent pas seulement les APIs. Elles déclenchent souvent des écritures en série, des requêtes supplémentaires, des vérifications de cohérence et parfois des verrous. Si la base de données devient le point de passage de tout, la contention apparaît : les requêtes s’empilent, les files se remplissent et la charge monte sans prévenir.
Une intégration n’est pas coûteuse parce qu’elle existe ; elle le devient quand elle allonge un chemin critique que l’utilisateur ne peut pas contourner.
Comment diagnostiquer vite sans casser la production ?
Le diagnostic utile se fait par élimination, pas par intuition. Il faut d’abord identifier le périmètre touché, puis mesurer le temps passé à chaque étape, et seulement ensuite chercher la cause technique. Cette séquence réduit le bruit et évite de désactiver au hasard le mauvais composant.
- Isoler le parcours : notez l’action lente exacte, l’heure, le volume et le profil utilisateur touché.
- Comparer avant / après : mesurez la même action avec et sans la nouvelle intégration si un test de désactivation est possible.
- Mesurer les temps internes : API, base de données, traitements différés, files d’attente, cache, rendu front.
- Lire les traces : cherchez les appels longs, les erreurs répétées, les boucles de reprise et les timeouts.
- Reproduire avec un petit volume : si le produit devient rapide sur un jeu de données réduit, le problème est probablement lié à la charge ou aux volumes.
| Symptôme observé | Cause probable | Test rapide | Action prioritaire |
|---|---|---|---|
| Ouverture d’écran plus lente | Appels externes en chaîne | Mesurer chaque requête API | Découper, paralléliser, mettre en cache |
| Enregistrement qui bloque | Écriture lourde en base | Profiler les requêtes et les verrous | Optimiser les requêtes et les index |
| Synchronisation qui déborde | File d’attente saturée | Comparer backlog et temps de traitement | Déporter, lisser, prioriser |
| Lenteur par pics | Dépendance tierce instable | Corréler avec les heures et les timeouts | Ajouter timeout, retry, circuit breaker |
Quelles causes corriger en priorité ?
La priorité n’est pas toujours la cause la plus visible, mais celle qui touche le chemin utilisateur le plus fréquent. Dans un diagnostic de performance, on commence par ce qui bloque l’expérience au quotidien : appels externes trop bavards, synchronisation synchrone, base de données sursollicitée et traitement différé mal équilibré.
Intégration trop bavarde ou mal conçue
Un système qui interroge trop souvent un service tiers finit par payer chaque aller-retour. Si la même donnée est récupérée à répétition, si les payloads sont trop lourds, ou si l’application appelle une API alors qu’un cache suffirait, la latence grimpe. Là, la correction la plus rentable est souvent de réduire la fréquence et de ne récupérer que ce qui est utile.
- Limiter les appels non essentiels.
- Réduire la taille des réponses échangées.
- Utiliser une mise en cache là où la donnée ne change pas à chaque seconde.
- Créer des délais d’attente et des reprises raisonnables, sans relancer en boucle.
Base de données sollicitée au-delà du raisonnable
Quand une intégration ajoute des écritures en masse, la base peut devenir le goulot. Les requêtes non optimisées, les index absents, les jointures trop coûteuses ou les verrous de mise à jour sont des suspects classiques. C’est souvent là que le produit paraît “lent partout”, alors que le vrai point de blocage est localisé dans quelques tables ou quelques requêtes.
Tâches asynchrones mal maîtrisées
Un bon SaaS garde l’action utilisateur courte et renvoie le reste au traitement différé. Si les files d’attente grossissent, si les workers ne suivent plus, ou si le produit attend la fin d’un job au lieu de l’absorber en arrière-plan, la performance perçue s’effondre. Le symptôme le plus parlant : un écran semble réagir, puis se fige au moment de la finalisation.
Dépendances tierces instables
Les services externes ne se comportent pas toujours de façon stable selon l’heure, la région ou la charge. Un connecteur qui tient à midi peut ralentir à 9 h 00, puis repasser au vert. Pour trier cela, il faut suivre les délais de chaque dépendance dans le temps et comparer les périodes où le SaaS va bien avec celles où il se dégrade.
Comment corriger sans casser l’existant ?
La correction doit aller du plus rapide au plus structurel. On commence par soulager le parcours critique, puis on réorganise les échanges internes. L’objectif n’est pas seulement de faire baisser la latence aujourd’hui, mais d’empêcher le prochain ajout d’intégration de réintroduire la même panne sous une autre forme.
Si vous pilotez aussi vos outils métiers, gardez la même logique d’arbitrage que pour un arbitrage CRM simple ou avancé ou pour un tableau de bord KPI lisible : chaque ajout doit prouver son utilité et son coût réel, y compris en performance.
Mesures rapides
- Retirer ou désactiver temporairement les appels non essentiels.
- Mettre en cache les réponses stables ou peu changeantes.
- Décaler les traitements secondaires hors du chemin utilisateur.
- Réduire la fréquence des synchronisations et des webhooks redondants.
Corrections structurelles
- Repenser la séparation entre interface, orchestration et traitement différé.
- Optimiser les requêtes et les schémas de données.
- Instrumenter les dépendances externes avec des traces et des seuils.
- Ajouter un contrôle performance à chaque nouvelle intégration.
Comment prévenir le prochain ralentissement ?
La prévention tient surtout à la gouvernance. Dès qu’un SaaS accumule des intégrations, il faut traiter la performance comme une contrainte d’architecture, pas comme un effet secondaire. Cela passe par des seuils de surveillance, des tests de charge sur les parcours critiques et une revue systématique de l’impact avant mise en production.
Dans la pratique, l’équipe doit pouvoir répondre à trois questions simples : qu’est-ce qui a changé, qu’est-ce qui a ralenti, et quel parcours client a été touché. Sans cette discipline, on finit avec une pile d’intégrations difficiles à maintenir et un ralentissement SaaS qu’on détecte trop tard.
Pour suivre cela dans la durée, construisez un cadre de mesure comparable à celui d’un outil de notes de frais bien choisi : moins de fonctionnalités décoratives, plus de signaux utiles, et une lecture claire des frictions réelles.
Gouvernance des intégrations
- Valider l’impact performance avant tout déploiement majeur.
- Définir des seuils d’alerte simples sur le temps de réponse et les files d’attente.
- Documenter les dépendances critiques, leurs timeouts et leurs plans de reprise.
- Tester les parcours les plus rentables ou les plus sensibles au moins à chaque changement majeur.
Routine d’observation
- Suivre les temps de réponse par route et par type d’utilisateur.
- Comparer les versions avant et après chaque intégration.
- Conserver un journal des incidents, même quand la cause n’est pas encore confirmée.
- Relier les pics de latence aux volumes, aux horaires et aux services tiers sollicités.
Sources utiles à consulter
- OpenTelemetry : utile pour instrumenter les traces, les métriques et les logs sans dépendre d’un seul outil.
- web.dev : utile pour les méthodes de mesure de performance et la lecture des métriques d’expérience.
- Documentation officielle de chaque API tierce : utile pour les limites de débit, les délais d’attente et les webhooks.
Quand faire appel à une expertise plus poussée ?
Il faut escalader dès que le ralentissement touche plusieurs couches à la fois et que les tests simples ne séparent plus clairement la cause. Si la base de données, les workers, les APIs et le front semblent tous impliqués, le diagnostic dépasse le dépannage standard. À ce stade, l’enjeu n’est plus de “trouver un bug”, mais de reconstruire la chaîne de performance.
Demandez une expertise plus poussée quand le problème impacte les clients, les revenus ou la capacité de support. C’est aussi le bon moment si plusieurs intégrations se cumulent, si les temps de réponse varient fortement selon les heures, ou si l’on voit revenir les mêmes symptômes après chaque correctif superficiel.
À retenir
- ⚙️ Un ralentissement après intégrations se diagnostiquer par parcours, pas par intuition globale.
- 🔎 Mesurez d’abord les appels externes, la base de données et les files d’attente.
- 🧱 Corrigez en priorité le chemin utilisateur le plus fréquent et le plus visible.
- 🛡️ Ajoutez des seuils de performance avant chaque nouvelle intégration.
- 📊 Sans traces ni journalisation, le diagnostic devient vite une suite d’hypothèses.
FAQ
Quels sont les premiers signes d’un SaaS qui ralentit après intégrations ?
Le premier signal est souvent une action précise qui prend plus de temps qu’avant : ouverture d’écran, sauvegarde, synchronisation ou import. Si la lenteur varie selon l’heure ou le volume, il faut suspecter une dépendance externe, une file d’attente ou une base de données sous pression.
Comment savoir si le problème vient de l’API tierce ou de mon application ?
Il faut mesurer séparément le temps passé dans votre code et le temps passé à attendre la réponse externe. Si la trace montre que l’application attend surtout une API lente, la dépendance est en cause. Si le temps est perdu avant ou après l’appel, le problème est plutôt interne.
Faut-il désactiver une intégration pour tester ?
Oui, si c’est possible sans risque pour la production. C’est souvent le moyen le plus rapide de vérifier l’impact réel d’une intégration sur le temps de réponse. Faites-le de manière contrôlée, sur un périmètre limité, et comparez les mesures avant et après.
La mise en cache peut-elle vraiment aider ?
Oui, mais seulement pour les données qui supportent un léger décalage de fraîcheur. Le cache réduit les appels redondants, soulage la base de données et améliore la latence perçue. En revanche, il ne corrige pas une intégration mal conçue ou un traitement synchrone trop lourd.
Quand faut-il revoir l’architecture ?
Quand les correctifs rapides ne tiennent pas dans la durée, ou quand chaque nouvelle intégration recrée la même lenteur sous une autre forme. À ce stade, il faut revoir la séparation entre interface, orchestration, traitements différés et dépendances externes.