Pipeline de déploiement continu : comprendre son rôle et fiabiliser vos mises en production
Le pipeline de déploiement continu est une chaîne automatisée qui fait passer un changement de code de la validation à la mise en production, avec des contrôles à chaque étape. Son intérêt n’est pas seulement d’aller plus vite : il réduit les gestes manuels, rend les déploiements plus reproductibles et limite les erreurs évitables.
Pour bien le comprendre, il faut distinguer intégration continue, livraison continue et déploiement continu, puis regarder ce que le pipeline teste, construit, publie et surveille. C’est là que la fiabilisation se joue : dans la qualité des vérifications, la lisibilité de la chaîne et la capacité à revenir en arrière sans stress.
En bref
🧭 Le pipeline de déploiement continu automatise le chemin du code jusqu’en production, avec des contrôles répétés et traçables.
🧪 Les tests automatisés et les contrôles qualité sont le cœur du dispositif : sans eux, l’automatisation accélère aussi les erreurs.
🔁 Un bon pipeline prévoit le retour arrière, la surveillance applicative et des étapes simples à relire en cas d’incident.
📉 L’objectif n’est pas de tout automatiser d’un coup, mais de fiabiliser d’abord les étapes qui génèrent le plus de friction.
Qu’est-ce qu’un pipeline de déploiement continu ?
Un pipeline de déploiement continu est une chaîne d’étapes automatisées qui prend une modification de code, la vérifie, la teste, la prépare puis la pousse vers un environnement cible, parfois jusqu’en production. Sa fonction est simple : rendre le chemin du code plus prévisible, plus visible et moins dépendant des manipulations manuelles.
Dans la pratique, ce pipeline ne remplace pas le jugement de l’équipe. Il standardise les vérifications, centralise les décisions techniques répétitives et évite que chaque déploiement soit exécuté “à la main” différemment du précédent. C’est ce passage du geste artisanal à la procédure stable qui change la fiabilité.
Ce que le pipeline standardise
- la validation du code avant toute diffusion ;
- les tests automatisés de non-régression ;
- la construction de l’artefact ou de l’image ;
- les contrôles qualité et de sécurité ;
- le déploiement progressif ou direct ;
- la surveillance applicative après mise en production.
Quelle différence entre intégration continue, livraison continue et déploiement continu ?
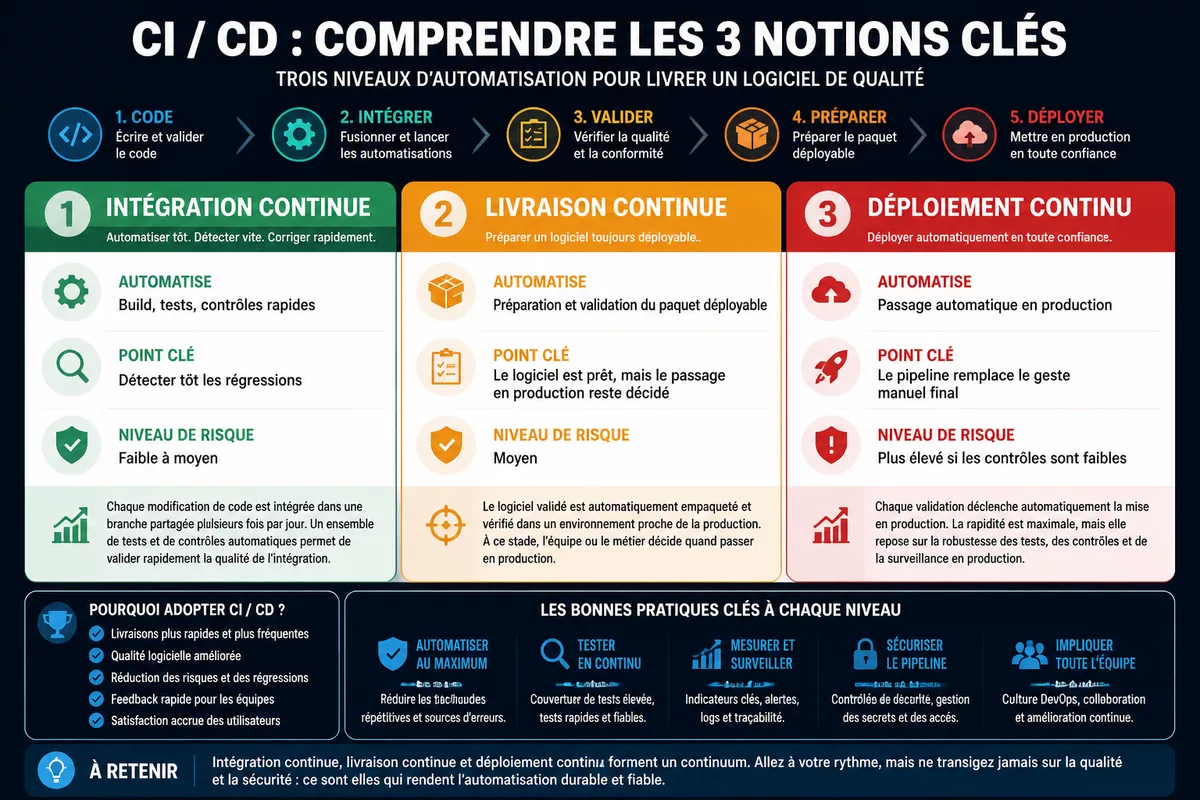
La différence est surtout une question de niveau d’automatisation. L’intégration continue vérifie vite le code à chaque changement. La livraison continue prépare un logiciel prêt à être mis en production. Le déploiement continu, lui, pousse automatiquement en production quand les contrôles sont passés.
| Notion | Ce qui est automatisé | Point clé | Niveau de risque |
|---|---|---|---|
| Intégration continue | Build, tests, contrôles rapides | Détecter tôt les régressions | Faible à moyen |
| Livraison continue | Préparation et validation du paquet déployable | Le logiciel est prêt, mais le passage en production reste décidé | Moyen |
| Déploiement continu | Passage automatique en production | Le pipeline remplace le geste manuel final | Plus élevé si les contrôles sont faibles |
Autrement dit, on ne parle pas de trois outils différents, mais de trois paliers d’automatisation. Plus on avance, plus il faut des tests solides, des critères d’arrêt clairs et une surveillance fiable. Sinon, la vitesse gagne, mais la maîtrise recule.
Pourquoi un pipeline fiabilise-t-il les mises en production ?
Un pipeline fiabilise les déploiements parce qu’il remplace les opérations répétitives et fragiles par une séquence stable, vérifiable et rejouable. Il réduit les oublis, fait sortir les erreurs plus tôt et donne à l’équipe un cadre commun pour décider si un changement peut passer ou non.
Les trois gains les plus concrets
- Moins d’erreurs humaines : moins de commandes saisies à la main, moins d’actions oubliées, moins d’écarts entre deux déploiements.
- Détection plus précoce : un test cassé au début du pipeline coûte moins cher qu’un incident découvert après diffusion.
- Traçabilité meilleure : chaque étape laisse une trace, ce qui aide à comprendre ce qui a changé et quand.
Un pipeline fiable n’élimine pas les incidents ; il réduit le nombre d’occasions de les provoquer et accélère leur détection.
Cette nuance compte. Le pipeline de déploiement continu ne promet pas une production parfaite. Il rend surtout les déploiements plus observables, plus cohérents et plus simples à corriger. C’est exactement ce qui change la charge mentale des équipes quand les mises en production deviennent fréquentes.
Le rôle du retour arrière
Le retour arrière n’est pas un luxe. Dans un système bien pensé, il fait partie du pipeline de déploiement continu au même titre que les tests. Si un changement dégrade un service, revenir à une version stable doit être rapide, documenté et techniquement simple. Sans cela, l’automatisation accélère aussi la propagation du problème.
Le bon objectif n’est pas le déploiement automatique à tout prix, mais le déploiement automatique quand les contrôles rendent l’automatisation acceptable.
Comment fonctionne un pipeline, étape par étape ?
Le pipeline de déploiement continu suit généralement une suite d’étapes fixes. Chaque étape a un rôle précis : valider, tester, construire, vérifier, déployer et surveiller. Plus la séquence est claire, plus l’équipe sait où un changement peut être arrêté sans bloquer toute la chaîne.
- Validation du code : le changement est intégré au dépôt et vérifié rapidement.
- Tests automatisés : les tests unitaires, d’intégration ou end-to-end détectent les régressions.
- Construction : l’application, l’image ou l’artefact est généré de façon reproductible.
- Contrôles qualité : linting, analyse statique, sécurité et conformité technique.
- Mise en production : le changement est publié selon la stratégie choisie.
- Surveillance applicative : métriques, logs et alertes confirment que tout tient en charge.
Ce qu’il faut surveiller après le déploiement
- les erreurs applicatives et le taux d’échec des requêtes ;
- la latence et les temps de réponse ;
- les indicateurs métier utiles au produit ;
- les alertes d’infrastructure ou de sécurité ;
- la stabilité des dépendances et des services voisins.
La surveillance post-déploiement est souvent sous-estimée. Pourtant, c’est elle qui dit si le pipeline de déploiement continu a réellement amélioré la fiabilité ou s’il a juste déplacé le problème plus loin dans le temps.
Comment choisir le bon niveau d’automatisation ?
Le bon niveau d’automatisation dépend moins d’un dogme que du contexte : taille de l’équipe, fréquence de livraison, niveau de risque et maturité des tests. Commencez par automatiser ce qui est répétitif, sensible aux oublis et simple à vérifier. Le reste peut venir ensuite, une fois la chaîne éprouvée.
Avant de figer la cible, un cahier des charges logiciel bien cadré aide à distinguer les besoins réels des envies de confort. C’est utile pour éviter un pipeline trop lourd, trop coûteux à maintenir ou trop sophistiqué pour l’état du projet.
Grille simple pour décider
- Petit projet ou équipe réduite : automatiser les tests critiques et la construction, puis garder un contrôle manuel sur la production.
- Produit SaaS en croissance : ajouter les contrôles qualité, les déploiements progressifs et le retour arrière scripté.
- Application sensible : renforcer les validations, les droits d’accès, la surveillance et les règles de blocage.
Critères de choix utiles
- la fréquence des mises en production ;
- le coût d’un incident ;
- la qualité des tests existants ;
- la capacité à surveiller la production en temps réel ;
- la simplicité du retour à une version stable.
Quelles bonnes pratiques appliquer dès le départ ?
Un pipeline de déploiement continu devient fiable quand il reste lisible, testable et sécurisé. Il ne suffit pas de l’outiller : il faut aussi limiter les exceptions, protéger les accès sensibles et éviter de multiplier les étapes qui n’apportent aucun signal utile.
Les pratiques qui donnent le plus de rendement
- Automatiser d’abord les étapes répétitives : elles sont souvent les plus sujettes aux oublis.
- Écrire des tests réellement utiles : peu importe le volume si les tests ne détectent pas les régressions importantes.
- Protéger les secrets : variables sensibles, clés et jetons doivent rester hors du code source.
- Réduire la surface des privilèges : donner le minimum d’accès nécessaire aux outils de déploiement.
- Prévoir le retour arrière dès le début : une restauration simple vaut mieux qu’un dépannage improvisé.
Ce qu’il faut surveiller côté sécurité
- les droits des comptes techniques ;
- la gestion des secrets et des variables d’environnement ;
- la signature ou la vérification des artefacts ;
- la séparation entre environnements de test et de production ;
- les journaux d’audit du pipeline.
La fiabilité ne vient pas d’un outil seul. Elle vient d’une chaîne cohérente : tests utiles, règles simples, droits limités et surveillance claire.
Exemple concret de chaîne de déploiement
Prenons un cas indicatif : une équipe produit de cinq personnes modifie une fonctionnalité de recherche. Sans pipeline, le déploiement suppose plusieurs manipulations manuelles, une vérification orale et un suivi dispersé après mise en ligne. Avec un pipeline de déploiement continu, la même modification passe par des tests, un build reproductible, une validation automatique puis une surveillance ciblée après publication.
Si la mise en production manuelle prenait 20 à 30 minutes et mobilisait deux personnes, l’automatisation peut ramener le temps actif à quelques minutes, sans supprimer le temps de contrôle. L’intérêt n’est pas seulement le gain de temps. C’est surtout la baisse du risque d’oubli et la possibilité de revenir vite à une version saine si une alerte remonte.
Ce gain reste conditionnel. Il dépend de la qualité des tests, de la clarté des étapes et du sérieux de la surveillance. Un pipeline de déploiement continu mal conçu peut livrer plus souvent… mais aussi plus souvent livrer des problèmes.
Quelles erreurs fréquentes faut-il éviter ?
Les problèmes viennent rarement de l’idée elle-même. Ils apparaissent quand l’équipe automatise trop tôt, trop loin ou sans critères de contrôle. Un pipeline de déploiement continu ne compense pas une base de tests faible, des droits trop larges ou une production mal observée.
Les pièges les plus courants
- Automatiser sans contrôle : la vitesse augmente, mais la qualité ne suit pas.
- Accumuler des étapes inutiles : un pipeline illisible ralentit l’équipe au lieu de l’aider.
- Négliger la production : sans monitoring, les incidents arrivent trop tard pour être corrigés vite.
- Oublier le retour arrière : le déploiement devient un point de tension au lieu d’être une routine.
- Confondre livraison continue et déploiement continu : les responsabilités ne sont pas les mêmes.
Signaux d’alerte à prendre au sérieux
- les déploiements sont fréquents mais les incidents aussi ;
- personne ne sait quelle version tourne en production ;
- les tests sont longs, fragiles ou rarement lancés ;
- le retour arrière demande une manipulation manuelle lourde ;
- les alertes arrivent après la plainte des utilisateurs.
Sources utiles à consulter
Pour approfondir un pipeline de déploiement continu sans rester au niveau des généralités, il vaut mieux lire la documentation qui décrit réellement la chaîne, les limites et les options de contrôle. Voici les références les plus utiles côté pratique :
- GitLab CI/CD — utile pour comprendre une chaîne complète, les jobs, les runners et les artefacts ; vigilance : garder un regard critique sur les choix d’outil.
- GitHub Actions — pratique pour voir comment organiser des workflows, des déclencheurs et des contrôles ; vigilance : ne pas confondre simplicité d’usage et maturité d’architecture.
- Jenkins — pertinent pour les pipelines plus personnalisés ou les environnements historiques ; vigilance : le maintien peut vite devenir plus coûteux qu’attendu.
- Documentation des pratiques DevOps — utile pour replacer le pipeline dans une chaîne plus large de qualité, d’exploitation et d’observabilité.
À retenir
- 🧩 Le pipeline de déploiement continu standardise le passage du code vers la production.
- 🧪 Les tests automatisés et les contrôles qualité portent la fiabilité réelle.
- 🔁 Le retour arrière doit être prévu avant le premier incident, pas après.
- 📡 La surveillance après déploiement compte autant que la mise en production elle-même.
- ⚖️ L’automatisation utile commence petit, puis s’étend selon le risque et la maturité.
FAQ
À quoi sert un pipeline de déploiement continu ?
Il sert à automatiser et à sécuriser le chemin du code jusqu’en production. L’objectif est de réduire les manipulations manuelles, de détecter les problèmes plus tôt et de rendre les mises en production plus prévisibles.
Quelle différence avec l’intégration continue ?
L’intégration continue vérifie surtout que les changements de code s’assemblent et passent les premiers tests. Le pipeline de déploiement continu va plus loin : il ajoute la construction, la validation, le déploiement et souvent la surveillance post-livraison.
Est-ce adapté aux petites équipes ?
Oui, à condition de commencer simplement. Une petite équipe gagne souvent beaucoup en automatisant les tests critiques et la construction avant de viser un déploiement totalement automatique.
Comment sécuriser un déploiement automatique ?
Il faut des tests utiles, des accès restreints, une gestion propre des secrets et un retour arrière rapide. Sans ces garde-fous, l’automatisation accélère aussi les erreurs.
Que faire en cas de problème après la mise en production ?
Il faut surveiller les métriques, confirmer l’étendue de l’incident, puis revenir vite à une version stable si nécessaire. Le plus important est de disposer d’un plan de restauration simple avant le déploiement.