Extraction de texte OCR : comprendre quand cette technologie vous fait vraiment gagner du temps
L’extraction de texte OCR est devenue un réflexe pour numériser des documents, automatiser la saisie et rendre des archives enfin exploitables. Pourtant, cette technologie ne fait pas toujours gagner du temps dans tous les contextes. Selon la qualité du document, son format, son niveau de complexité et le résultat attendu, l’OCR peut être un accélérateur puissant… ou au contraire une étape supplémentaire qui demande encore beaucoup de correction humaine.
Dans cet article, vous allez découvrir quand l’extraction de texte OCR est réellement rentable, comment elle fonctionne, ses limites, et les critères essentiels pour choisir une solution adaptée à vos usages professionnels ou personnels.
OCR : définition simple et principe de fonctionnement
L’OCR, pour Optical Character Recognition, désigne la reconnaissance optique de caractères. En pratique, un logiciel analyse une image, une photo ou un document scanné, identifie les formes qui correspondent à des lettres, puis les convertit en texte exploitable. Le résultat peut ensuite être copié, recherché, modifié, exporté vers un tableur ou intégré à un logiciel métier.
De l’image au texte exploitable
Le principe est simple sur le papier, mais plus technique dans les faits. Un outil d’extraction de texte OCR commence généralement par repérer les zones utiles du document, séparer le fond du texte, détecter les lignes et les caractères, puis comparer les formes observées à des modèles appris. Les solutions récentes vont plus loin en utilisant de l’intelligence artificielle pour reconnaître la mise en page, les tableaux, les champs de formulaire ou les colonnes.
Le vrai intérêt n’est pas seulement de transformer une image en texte. C’est surtout de rendre un document recherchable, réutilisable et automatisable. Un PDF scanné devient consultable par mots-clés, un reçu peut alimenter un logiciel comptable, et un contrat peut être analysé plus rapidement.
Pourquoi la qualité du document change tout
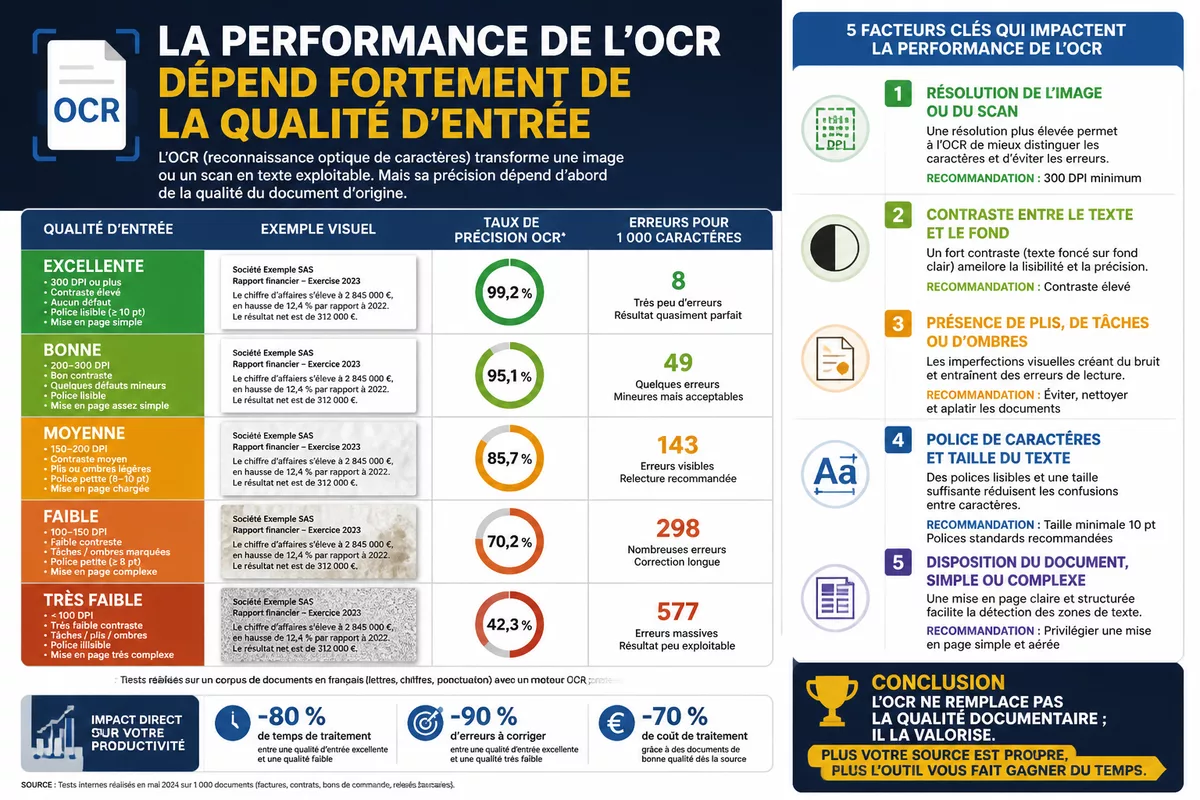
La performance de l’OCR dépend fortement de la qualité d’entrée. Un document propre, net, bien éclairé et correctement orienté donne de meilleurs résultats qu’une photo prise rapidement avec un téléphone. Les facteurs qui influencent le résultat sont nombreux :
- la résolution de l’image ou du scan ;
- le contraste entre le texte et le fond ;
- la présence de plis, de tâches ou d’ombres ;
- la police de caractères et la taille du texte ;
- la disposition du document, simple ou complexe.
Autrement dit, l’OCR ne remplace pas la qualité documentaire. Il la valorise. Plus votre source est propre, plus l’outil vous fait gagner du temps.
Dans quels cas l’OCR devient vraiment utile
L’extraction de texte OCR prend tout son sens lorsqu’il faut traiter beaucoup de documents, retrouver une information précise ou supprimer une saisie manuelle répétitive. Dans ces cas, le temps économisé peut être considérable.
Numériser des factures, devis et reçus
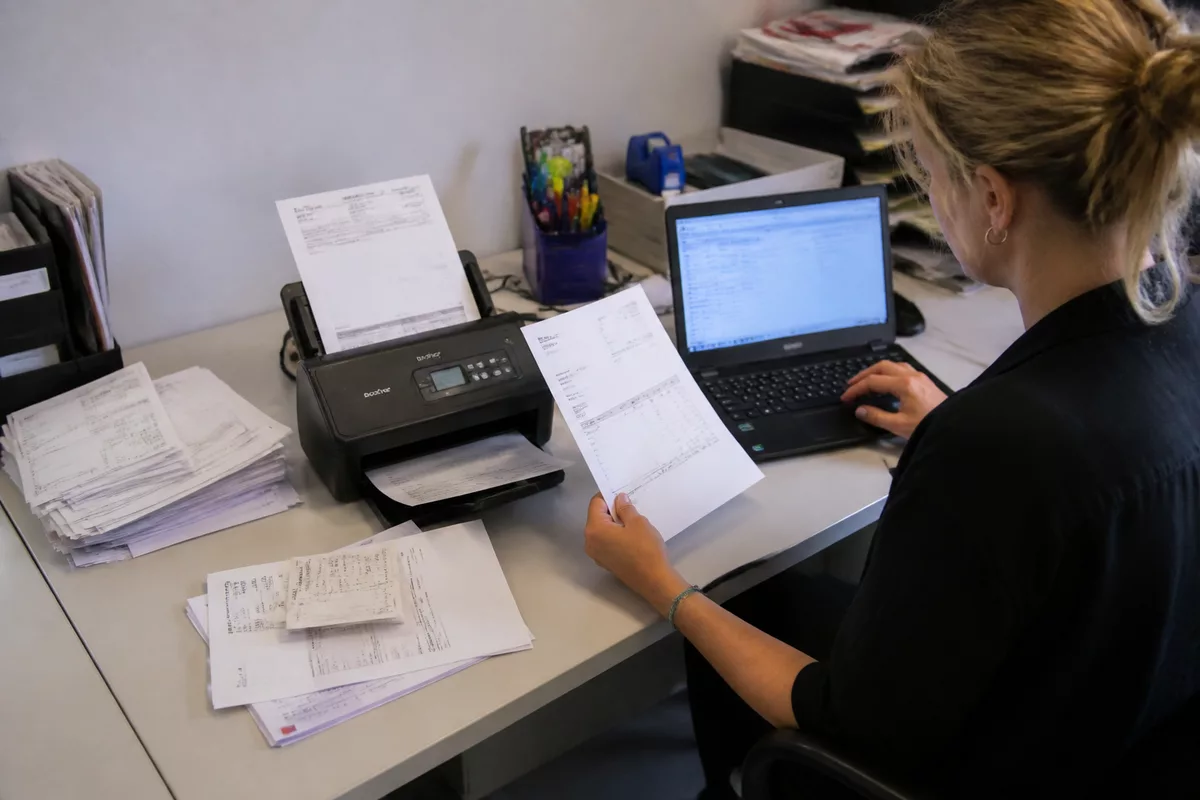
Les documents administratifs et comptables sont parmi les meilleurs cas d’usage. Une facture contient souvent des éléments répétitifs comme le numéro, la date, le montant TTC, la TVA ou le nom du fournisseur. L’OCR permet de récupérer ces informations et de les envoyer vers un outil de gestion, un ERP ou un tableau de suivi.
Pour un indépendant, un service comptable ou une PME, cela évite de retaper manuellement des dizaines de lignes chaque semaine. Le gain de temps devient particulièrement visible quand le volume augmente. Même si une vérification reste nécessaire, la saisie est déjà largement réduite.
Exploiter des contrats, formulaires et archives
L’OCR est aussi très utile pour les documents juridiques et administratifs. Des contrats signés, des dossiers clients, des formulaires papier ou des archives historiques peuvent être convertis en texte consultable. Cela permet de rechercher rapidement un nom, une clause, une date ou une référence sans parcourir chaque page à la main.
Dans les archives, l’objectif n’est pas toujours la modification du texte. Il s’agit souvent d’indexer l’information, de la retrouver facilement et de limiter le temps passé à fouiller des dossiers numérisés. Dans ce contexte, l’OCR améliore surtout la consultation et la traçabilité.
Rechercher dans des PDF scannés
Beaucoup d’utilisateurs confondent fichier PDF et document texte. Un PDF peut en réalité être une simple image scannée. Sans OCR, il est impossible de chercher un mot à l’intérieur. Avec une bonne reconnaissance de texte, le document devient consultable comme un texte classique.
Cette fonctionnalité est très utile pour les bibliothèques documentaires, les services qualité, les ressources humaines ou les équipes support qui doivent retrouver rapidement un contenu précis. L’extraction de texte OCR transforme alors une masse de fichiers passifs en base documentaire exploitable.
Quand l’OCR apporte peu de valeur
Malgré ses atouts, l’OCR n’est pas systématiquement la meilleure option. Dans certains cas, son intérêt est faible, voire contre-productif si le document est déjà exploitable autrement.
Documents déjà modifiables
Si vous disposez déjà d’un fichier Word, d’un PDF généré depuis un logiciel ou d’un texte exporté depuis une application, l’OCR n’apporte généralement rien. Le document contient déjà du texte natif. Lancer une reconnaissance optique revient alors à ajouter une étape inutile, parfois même à introduire des erreurs de conversion.
Il est donc important de distinguer un document image d’un document texte. L’OCR est conçu pour le premier, pas pour le second.
Textes manuscrits difficiles à reconnaître
L’écriture manuscrite reste l’un des défis les plus délicats pour l’extraction de texte OCR. Certains outils récents réussissent bien des notes simples, des formulaires ou des écritures très lisibles. En revanche, dès que l’écriture est rapide, stylisée ou irrégulière, la fiabilité baisse nettement.
Si votre besoin repose essentiellement sur des notes manuscrites, il faut vérifier très concrètement les performances de l’outil avant de l’adopter. Dans certains cas, une transcription manuelle ou un autre procédé de saisie sera plus rapide au final.
Images floues ou documents très dégradés
Lorsque la source est mauvaise, l’OCR doit deviner ce qui est écrit. Un document flou, penché, partiellement coupé ou surexposé augmente fortement le taux d’erreur. Cela concerne aussi les photocopies anciennes, les papiers jaunis, les impressions de faible qualité ou les photos prises dans de mauvaises conditions.
Dans ces cas, le temps gagné au début peut être perdu ensuite en correction. C’est là que l’on comprend une règle essentielle : l’OCR accélère le traitement, mais ne compense pas toujours une source de mauvaise qualité.
Comment obtenir un résultat fiable
Pour que l’extraction de texte OCR soit réellement rentable, il faut combiner un bon outil avec une méthode de préparation simple. Quelques gestes suffisent souvent à améliorer nettement le résultat.
Préparer les documents avant extraction
Avant de lancer l’OCR, il est utile de vérifier plusieurs points :
- scanner ou photographier à une résolution suffisante ;
- redresser l’image pour que le texte soit horizontal ;
- supprimer les ombres, les plis ou les éléments parasites ;
- choisir un contraste correct entre le fond et le texte ;
- regrouper les documents par type si la mise en page varie beaucoup.
Un document bien préparé limite les erreurs et réduit le temps de relecture. Dans de nombreux projets, cette étape de préparation est ce qui fait la différence entre un outil “moyen” et une vraie solution de productivité.
Choisir le bon niveau d’automatisation
Tous les besoins ne nécessitent pas le même degré d’automatisation. Pour quelques documents par semaine, un outil simple avec export manuel peut suffire. Pour des volumes plus importants, il peut être pertinent d’automatiser l’archivage, l’extraction de champs précis ou l’envoi vers un logiciel tiers.
L’enjeu est de trouver le bon équilibre entre vitesse et contrôle. Une automatisation trop poussée peut être contre-productive si les documents sont très hétérogènes. À l’inverse, un processus trop manuel annule l’intérêt de l’OCR. Le bon choix dépend du volume, de la répétitivité et du niveau de précision attendu.
Corriger et vérifier les erreurs
Aucune solution n’est parfaite à 100 %. Même les meilleurs systèmes d’extraction de texte OCR commettent des erreurs sur certains caractères, chiffres, accents ou mises en page complexes. Il faut donc prévoir une phase de contrôle, surtout pour les documents sensibles : contrats, pièces comptables, dossiers réglementaires ou informations clients.
Une bonne pratique consiste à vérifier en priorité les zones critiques :
- noms propres ;
- numéros de facture ou d’identification ;
- montants et dates ;
- clauses importantes ;
- champs obligatoires destinés à un logiciel métier.
Cette vérification ciblée permet de conserver un haut niveau de fiabilité sans relire tout le document ligne par ligne.
Comment choisir une solution d’OCR
Le marché propose des solutions très différentes, allant des outils gratuits intégrés à des plateformes spécialisées. Pour choisir correctement, il faut partir de vos besoins réels et non d’un simple argument de promesse technologique.
Les critères à comparer avant de se décider
Plusieurs critères méritent d’être examinés avant d’adopter une solution :
- la précision sur vos types de documents ;
- la prise en charge des langues et des accents ;
- la reconnaissance de tableaux, colonnes et formulaires ;
- la vitesse de traitement ;
- les options d’export : texte, Word, Excel, PDF indexé ;
- la confidentialité des données ;
- la facilité d’intégration dans vos outils existants.
Un outil très performant sur des factures peut être moyen sur des formulaires. Il vaut donc mieux tester sur vos propres documents avant de généraliser.
Gratuit, intégré ou spécialisé : que privilégier
Les solutions gratuites conviennent souvent pour des besoins ponctuels : extraire quelques pages, lire un PDF scanné ou convertir une image en texte. Les outils intégrés à un système bureautique ou à un smartphone sont pratiques pour des usages courants et rapides.
Les solutions spécialisées sont plus adaptées aux environnements professionnels, notamment quand le volume est important, que les documents sont complexes ou que la fiabilité doit être élevée. Elles offrent souvent de meilleures fonctions de contrôle, d’automatisation et de reconnaissance de la mise en page.
Le bon choix dépend donc du rapport entre volume, complexité et coût de correction. Une solution bon marché peut devenir chère si elle vous oblige à reprendre manuellement une grande partie des résultats.
Questions fréquentes sur l’extraction de texte OCR
Quand l’OCR est-il vraiment utile ?
L’OCR est vraiment utile lorsque vous devez convertir des documents image en texte pour les rechercher, les archiver, les modifier ou en extraire des données. Il devient particulièrement rentable sur les factures, les reçus, les formulaires, les contrats et les PDF scannés en grand volume.
L’OCR fonctionne-t-il sur l’écriture manuscrite ?
Oui, mais avec des résultats variables. L’écriture manuscrite lisible et régulière peut être reconnue assez correctement, surtout sur des formulaires simples. En revanche, les écritures rapides, peu soignées ou très stylisées restent difficiles à traiter avec fiabilité.
Comment améliorer la précision de l’extraction ?
Pour améliorer la précision, il faut fournir une image nette, bien orientée et bien contrastée, utiliser un outil adapté à votre type de document et vérifier les zones sensibles après extraction. Une bonne préparation du document réduit souvent davantage les erreurs que le changement d’outil lui-même.
Peut-on utiliser l’OCR sur des PDF scannés ?
Oui, c’est même l’un des usages les plus courants. Un PDF scanné est souvent une suite d’images, et l’OCR permet d’en faire un document consultable par recherche textuelle. C’est très utile pour les archives, les dossiers administratifs et les bibliothèques documentaires.
Conclusion : identifier rapidement les bons cas d’usage
L’extraction de texte OCR fait vraiment gagner du temps quand elle supprime des tâches répétitives, rend des documents consultables et fluidifie la saisie d’informations. Elle est particulièrement efficace sur les documents imprimés, propres, structurés et produits en volume. En revanche, elle apporte moins de valeur sur les documents déjà éditables, les manuscrits complexes ou les fichiers très dégradés.
La bonne approche consiste à évaluer trois éléments avant de s’équiper : la qualité des documents, le volume à traiter et le niveau de précision attendu. Si ces trois points sont alignés, l’OCR peut devenir un véritable levier de productivité. Sinon, elle risque de déplacer le travail plutôt que de le réduire.
En résumé, l’OCR ne doit pas être choisie parce qu’elle est à la mode, mais parce qu’elle répond à un besoin concret. Quand le cas d’usage est clair, elle transforme une pile de documents en information exploitable, plus rapidement et avec moins d’effort.