Premier déploiement dans le nuage : les 7 erreurs fréquentes à éviter pour réussir sa mise en production
Un premier déploiement dans le nuage échoue rarement parce que le nuage “ne fonctionne pas”. Il échoue surtout quand le cadrage est flou, que les accès ne sont pas verrouillés, que les tests sont incomplets ou que le retour arrière n’a pas été préparé. Le vrai risque n’est pas le changement de plateforme, mais l’improvisation au moment de la bascule.
Dans cet article, vous allez repérer les erreurs de déploiement les plus courantes avant une mise en production dans le nuage, comprendre leurs conséquences concrètes et corriger ce qui bloque avant qu’il ne soit trop tard. L’objectif est simple : passer d’un premier passage dans le nuage “qui tient à peu près” à un lancement exploitable, mesuré et réversible.
En bref
🧭 Le point de rupture n’est pas la migration elle-même, mais la préparation de la mise en production.
💶 Les surcoûts viennent souvent d’un mauvais dimensionnement, d’environnements oubliés et d’alertes trop tardives.
🔐 Les droits d’accès, les secrets et la séparation test/production doivent être définis avant l’ouverture au trafic réel.
🛟 Un plan de retour arrière testé vaut mieux qu’une promesse rassurante le jour du déploiement.
Pourquoi un premier déploiement dans le nuage demande une préparation particulière ?
Parce qu’un déploiement cloud change la manière d’exploiter l’application, pas seulement l’endroit où elle tourne. Le modèle choisi influe sur le coût, le contrôle, la sécurité et la manière de surveiller le service. Sans cadrage, on se retrouve vite avec une architecture difficile à faire évoluer, à protéger et à piloter.
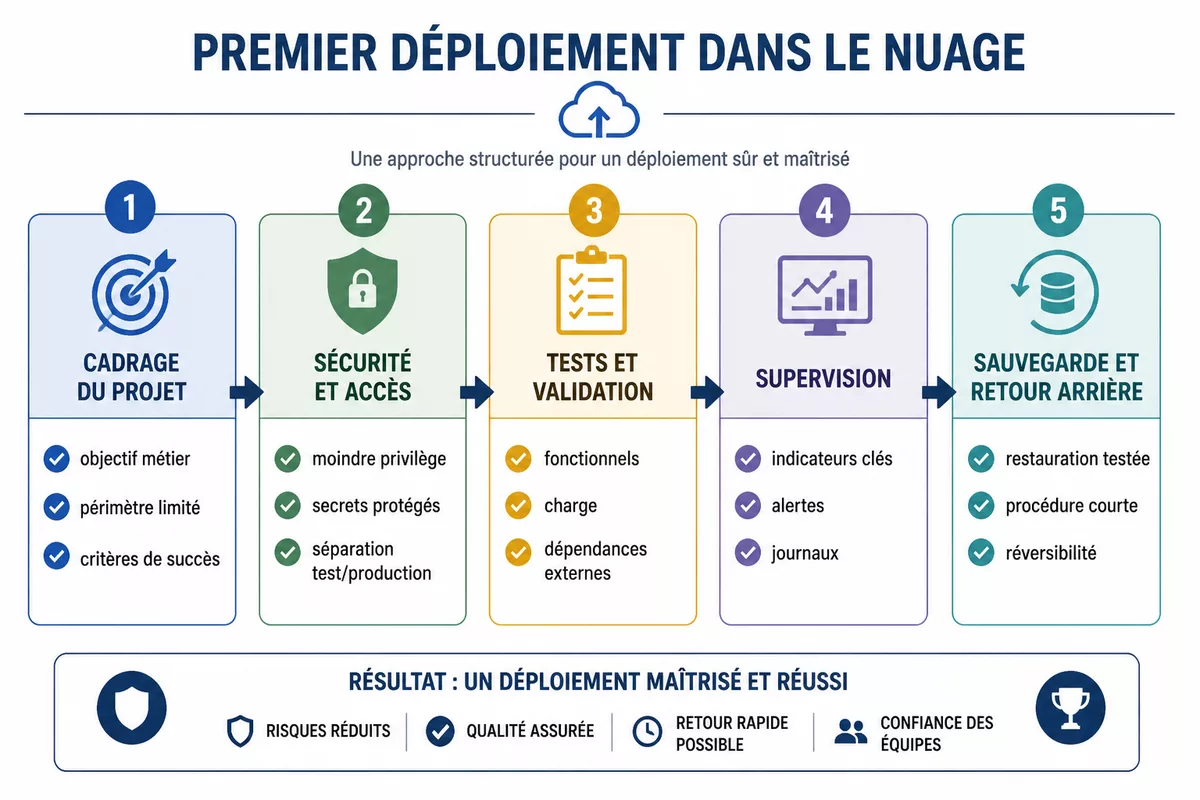
En pratique, le premier déploiement dans le nuage se gagne avant le jour J. Il faut décider ce qui est prioritaire, ce qui doit être testé, ce qui doit être observé et ce qui doit rester réversible. C’est exactement le genre de préparation que les guides officiels des grands fournisseurs mettent en avant dans leurs cadres d’architecture et de gouvernance.
La règle la plus utile reste simple : ce qui n’est pas testé avant la bascule se découvre en urgence après.
Si vous partez d’un site ou d’une application déjà en ligne, le bon réflexe est de lire le déploiement cloud comme un arbitrage, pas comme un saut de foi. Pour les questions de latence, de SLA ou de bande passante, un rappel utile se trouve dans lire une offre d’hébergement : le détail contractuel compte autant que la promesse commerciale.
Les 7 erreurs fréquentes à éviter
Voici la liste courte que beaucoup d’équipes auraient aimé avoir avant leur première mise en production dans le nuage. Le but n’est pas de tout complexifier, mais d’éviter les erreurs qui coûtent du temps, de l’argent ou de la crédibilité une fois le service ouvert.
- Se lancer sans cadrage clair du projet.
- Sous-estimer le budget et les consommations.
- Négliger la sécurité et les droits d’accès.
- Oublier les sauvegardes et le retour arrière.
- Lancer sans tests suffisants.
- Manquer de surveillance et d’alertes.
- Négliger l’automatisation et la documentation.
| Erreur | Signe visible | Conséquence probable | Correction utile |
|---|---|---|---|
| Cadrage flou | Périmètre qui change sans arrêt | Retards, arbitrages incohérents | Définir un objectif, un périmètre, des critères de succès |
| Budget sous-estimé | Ressources laissées actives | Facture surprise, gel des décisions | Mettre des alertes, suivre les consommations, couper le superflu |
| Droits mal gérés | Comptes trop ouverts | Risque de fuite ou de modification involontaire | Appliquer le moindre privilège et séparer les environnements |
| Sauvegarde absente | Pas de test de restauration | Perte de données, arrêt prolongé | Prévoir et tester une restauration réelle |
| Tests incomplets | Erreur découverte en production | Incident visible par les utilisateurs | Tester en conditions proches du réel |
| Supervision faible | Alertes trop nombreuses ou absentes | Diagnostic lent, incident tardif | Ne garder que quelques indicateurs utiles |
| Automatisation absente | Procédures faites à la main | Erreurs humaines et dépendance à une personne | Standardiser et documenter ce qui se répète |
Le point commun de ces erreurs est simple : elles ne se voient pas toujours au départ, mais elles apparaissent au moment où le service doit encaisser la charge, la supervision ou une panne. Le nuage ne pardonne pas l’approximation parce qu’il rend les écarts plus rapides, plus visibles et souvent plus coûteux.
Erreur 1 : se lancer sans cadrage clair du projet
Le premier déploiement dans le nuage déraille souvent parce que personne n’a tranché le vrai sujet : quel service doit être mis en ligne, pour quel usage, avec quel niveau de risque accepté. Sans cadrage, l’équipe additionne les bonnes idées au lieu de choisir la bonne trajectoire.
Pourquoi cette erreur arrive souvent
Le nuage donne une impression de souplesse qui pousse à démarrer vite. On veut “voir tourner” l’application avant d’avoir fixé les priorités métier, les dépendances techniques et les critères de succès. Résultat : l’architecture suit l’urgence du moment, pas l’objectif réel.
Conséquences possibles
- Périmètre qui grossit sans contrôle.
- Choix techniques contradictoires entre équipes.
- Difficulté à dire si la mise en production est réussie.
Comment l’éviter
- Écrire l’objectif principal en une phrase.
- Réduire le périmètre du premier lot.
- Définir trois critères de réussite mesurables.
Si vous hésitez encore entre plusieurs formes d’hébergement, le bon arbitrage n’est pas seulement financier. Il faut aussi comparer le niveau de contrôle, la charge d’exploitation et la marge de manœuvre technique. À ce stade, choisir entre VPS et dédié peut aider à situer le bon niveau d’engagement avant de passer au nuage.
Erreur 2 : sous-estimer le budget et les consommations
Le nuage peut coûter peu au départ puis devenir cher très vite si les ressources sont surdimensionnées, les environnements oubliés ou les flux réseau mal anticipés. La bonne réponse n’est pas de se méfier du cloud en bloc, mais de suivre les coûts comme un indicateur d’exploitation, pas comme une ligne secondaire.
Ce qui coûte souvent plus cher que prévu
- Instances trop puissantes pour la charge réelle.
- Stockage et sauvegardes non triés.
- Trafic entrant et sortant sous-estimé.
- Environnements de test laissés actifs.
Comment limiter la dérive
Mettez en place des alertes budgétaires avant la bascule, puis une revue de consommation régulière pendant les premiers jours. Le bon réflexe consiste à observer ce qui tourne réellement, à couper le provisoire et à ajuster la capacité après mesure, pas avant. Pour relier coût et paramétrage réseau, comprendre la lecture d’une offre d’hébergement évite plusieurs erreurs de lecture au moment du choix.
Un coût cloud n’est jamais “fini” le jour du déploiement ; il doit être surveillé comme la charge ou les erreurs applicatives.
Exemple chiffré indicatif
Si vous activez trois environnements de taille identique et qu’un seul n’est utile en production, vous payez potentiellement le double de l’usage utile pour un résultat identique à court terme. Ce n’est pas un montant officiel : c’est un exemple de logique de consommation. La bonne question est donc : quelles ressources doivent rester actives, et lesquelles peuvent être arrêtées après les tests ?
Erreur 3 : négliger la sécurité et les droits d’accès
Le premier passage dans le nuage révèle vite les failles de gouvernance : comptes partagés, secrets stockés n’importe où, droits trop larges ou séparation faible entre test et production. Le problème n’est pas seulement la sécurité théorique ; c’est la capacité à limiter les dégâts si un compte ou une clé est compromis.
Les oublis les plus fréquents
- Accès administrateur attribués par défaut.
- Clés d’API laissées dans un dépôt de code.
- Absence de séparation claire entre environnements.
- Journalisation insuffisante pour retracer une action.
Comment l’éviter
Le principe du moindre privilège doit être appliqué dès le départ : chacun reçoit l’accès strictement nécessaire, rien de plus. Ensuite, les secrets doivent être stockés dans un gestionnaire prévu pour cela, et les comptes sensibles protégés par une authentification robuste. Pour la continuité en cas d’incident, notre guide continuité d’activité donne un cadre utile.
Erreur 4 : oublier les sauvegardes et le retour arrière
Beaucoup d’équipes repoussent ce point parce qu’elles pensent que la première bascule se passera bien. En réalité, le plan de retour arrière n’est pas un luxe : c’est ce qui limite la durée d’un incident quand une version, une configuration ou une dépendance se comporte mal en production.
Pourquoi ce point est souvent repoussé
Le temps manque, le calendrier est serré, et la sauvegarde est perçue comme une étape défensive. Pourtant, si la restauration n’a pas été testée, la sauvegarde n’a qu’une valeur théorique. Ce qui compte, ce n’est pas d’en avoir une, c’est de savoir la réutiliser vite et sans ambiguïté.
Comment l’éviter
- Identifier les données et paramètres critiques.
- Définir la fréquence de sauvegarde adaptée au risque.
- Tester une restauration avant la mise en production.
- Écrire une procédure de retour arrière courte.
Si vous ne savez pas par où commencer, partez d’un scénario simple : “que fait-on si la version déployée casse le parcours de commande ?” La réponse doit tenir en quelques étapes, pas dans un document de vingt pages. Une procédure courte a plus de chances d’être appliquée sous pression qu’un plan trop ambitieux.
Erreur 5 : lancer sans tests suffisants
Un déploiement non testé finit souvent en incident visible par les utilisateurs. Le piège classique consiste à valider une fonction en environnement de test, puis à découvrir en production une dépendance externe, une montée en charge ou un paramètre réseau qui n’avait jamais été exercé.
Les tests à ne pas oublier
- Tests fonctionnels sur les parcours critiques.
- Tests de montée en charge sur les points sensibles.
- Vérification des dépendances externes.
- Tests de reprise après erreur.
Comment tester utilement
Ne cherchez pas à tout tester. Concentrez-vous sur ce qui casse le service si cela échoue : authentification, paiement, écriture en base, appel à une API tierce, restauration de données. Un environnement proche de la production vaut souvent mieux qu’un environnement “propre” mais trop simplifié.
Pour comprendre où se cachent les vrais ralentissements, il est souvent utile de croiser l’infra, l’application et le thème ou les dépendances techniques. Le guide trier serveur, thème et application aide à éviter les diagnostics trop rapides.
Un test réussi n’est pas un test rassurant : c’est un test qui a trouvé les cas qui pouvaient casser la mise en production.
Comment savoir si les tests sont suffisants avant la mise en production ?
Les tests sont suffisants quand ils couvrent les parcours critiques, les erreurs probables et le scénario de retour arrière, pas quand la liste est “bien remplie”. Si vous pouvez répondre clairement à ce qui se passe en cas de charge, de panne ou de restauration, vous êtes déjà plus proche d’une bascule propre.
Les signaux de maturité
- Le service fonctionne dans un environnement proche du réel.
- Les parcours critiques ont été validés de bout en bout.
- Un incident simulé a été joué au moins une fois.
- Les résultats des tests sont tracés et relus.
Erreur 6 : manquer de surveillance et d’alertes
Une application peut sembler fonctionner pendant des heures tout en dégradant silencieusement ses performances ou ses coûts. Sans supervision, l’équipe découvre les problèmes trop tard. Le nuage rend la surveillance plus simple à mettre en place, mais aussi plus indispensable, parce qu’un incident peut se propager plus vite.
Ce qui manque souvent au départ
- Tableaux de bord vraiment lisibles.
- Alerte déclenchée sur de vrais seuils utiles.
- Journaux centralisés et exploitables.
- Responsable identifié pour la lecture des alertes.
Comment l’éviter
Commencez petit : trois ou quatre indicateurs bien choisis valent mieux qu’un mur de métriques que personne n’ouvre. Surveillez ce qui affecte directement l’expérience utilisateur, puis ce qui permet de diagnostiquer rapidement une panne. La supervision n’a d’intérêt que si elle aide à décider vite.
Quand vous devez comprendre la cause d’un ralentissement, l’article identifier les vrais freins est un bon complément pour trier les causes applicatives et infrastructurelles.
Erreur 7 : négliger l’automatisation et la documentation
Un déploiement trop manuel fonctionne tant que tout le monde est disponible et concentré. Dès qu’une urgence, un congé ou un changement d’équipe arrive, la fragilité apparaît. La documentation et l’automatisation ne servent pas à faire joli : elles réduisent les erreurs répétées et rendent le service transmissible.
Les effets d’un démarrage trop manuel
- Actions différentes selon la personne qui opère.
- Reproduction difficile d’un déploiement réussi.
- Temps perdu à chercher la bonne procédure.
Comment l’éviter
Automatisez d’abord les étapes les plus répétitives : déploiement, configuration, vérification et restauration simple. Documentez ensuite le minimum vital : prérequis, ordre des opérations, seuils d’alerte et procédure de retour arrière. La règle pratique est limpide : ce qui doit être refait doit pouvoir être rejoué sans mémoire implicite.
Liste de vérification avant la mise en production
Cette liste ne remplace pas le travail d’architecture, mais elle évite les oublis de dernière minute. Si un point manque, le déploiement n’est pas prêt. Si plusieurs points manquent, il faut retarder la bascule plutôt que “voir après”.
- Objectif du premier déploiement validé.
- Périmètre limité et mesurable.
- Budget initial et alertes de consommation en place.
- Droits d’accès revus et secrets protégés.
- Sauvegarde et restauration testées.
- Tests fonctionnels et tests de charge exécutés.
- Supervision et alertes activées.
- Plan de retour arrière rédigé et compris.
- Procédure de déploiement documentée.
Étape 1 : vérifier le cadre
Relisez l’objectif, le périmètre et le niveau de risque accepté. C’est la seule façon d’éviter la dérive de scope qui transforme un premier déploiement en projet sans fin.
Étape 2 : vérifier l’exploitation
Contrôlez les accès, les journaux, les sauvegardes, les alertes et la procédure de retour arrière. Si un incident survient, c’est cette chaîne qui fera la différence entre une interruption courte et une panne prolongée.
Étape 3 : vérifier la réversibilité
Demandez-vous si vous pouvez revenir en arrière sans improvisation. Si la réponse est “pas vraiment”, la mise en production doit attendre.
Sources utiles à consulter
Pour aller plus loin, mieux vaut s’appuyer sur des références qui parlent d’architecture, de gouvernance et d’exploitation plutôt que sur des promesses commerciales. C’est particulièrement vrai quand on prépare un premier déploiement dans le nuage.
- Documentation Google Cloud sur les types de cloud computing : utile pour revoir public, privé, hybride et multicloud.
- Documentation SAP sur le cloud computing : pratique pour garder une vision simple des services fournis via Internet.
- Cadres d’architecture officiels des grands fournisseurs : utiles pour la sécurité, la supervision et la gouvernance.
Si vous devez faire le lien entre performance, capacité et arbitrage d’hébergement, la lecture d’une offre ne doit pas se limiter au prix d’appel. Les impacts sur la latence, la bande passante et le SLA comptent dès le premier jour.
Comment décider que le projet est prêt ?
Le projet est prêt quand vous pouvez basculer sans flou sur le périmètre, sans doute sur la sécurité, sans trou dans les sauvegardes et sans ambiguïté sur le retour arrière. Si un seul de ces points reste fragile, mieux vaut retarder la mise en production que corriger en urgence sous charge réelle.
À retenir
- 🧱 Le cadrage du premier déploiement dans le nuage conditionne toute la suite.
- 💸 Les coûts dérivent vite si la consommation n’est pas suivie dès le départ.
- 🔒 Les accès, les secrets et la séparation des environnements doivent être verrouillés.
- 🧪 Les tests utiles couvrent les parcours critiques, la charge et le retour arrière.
- 🛟 Une supervision simple, des alertes claires et une documentation courte font gagner du temps.
FAQ
Faut-il commencer par une architecture simple ou ambitieuse ?
Pour un premier déploiement dans le nuage, mieux vaut commencer simple et maîtrisable. Une architecture plus ambitieuse se justifie seulement si le besoin métier l’impose vraiment. Le but n’est pas de tout prévoir d’un coup, mais de pouvoir basculer proprement puis ajuster.
Quelle erreur coûte le plus cher au début ?
Le plus coûteux est souvent le mélange entre cadrage flou, droits trop larges et absence de surveillance. Cette combinaison crée à la fois du risque technique, du risque sécurité et du risque budgétaire. Quand plusieurs de ces points manquent, les corrections deviennent plus lentes et plus chères.
Combien de tests faut-il avant la mise en production ?
Il n’existe pas de nombre magique. Ce qui compte, c’est la couverture des parcours critiques, des dépendances et du retour arrière. Si vous n’avez pas testé ce qui casse le service, la liste de tests est probablement insuffisante, même si elle est longue.
Le plan de retour arrière est-il vraiment indispensable ?
Oui, surtout lors d’un premier passage dans le nuage. Sans retour arrière clair, une erreur de configuration ou une régression peut immobiliser l’équipe pendant longtemps. Un plan simple, testé et compris vaut mieux qu’un document trop lourd que personne n’ouvrira sous pression.
Faut-il surveiller les coûts dès le premier jour ?
Oui. Les consommations cloud peuvent varier rapidement, surtout si les ressources sont mal dimensionnées ou si des environnements restent actifs. Mettre des alertes dès le départ permet d’éviter les mauvaises surprises et de corriger la taille réelle des ressources avec des données concrètes.