Sauvegarde et continuité d’activité : éviter la perte de données sans sous-estimer les interruptions
La sauvegarde continuité d’activité est souvent résumée à une idée trop simple : “nous avons des copies, donc nous sommes protégés”. C’est le piège classique. Une sauvegarde peut exister, être récente, chiffrée, stockée hors site, et pourtant ne pas permettre de relancer un service dans un délai acceptable.
L’enjeu n’est donc pas seulement de copier des fichiers. Il faut savoir quelles données sont vitales, combien de perte l’organisation peut absorber, en combien de temps un service doit revenir, qui décide pendant l’incident et comment vérifier que la restauration fonctionne. C’est là que la sauvegarde, la restauration, le plan de reprise d’activité et le plan de continuité d’activité cessent d’être des mots techniques pour devenir un dispositif de résilience.
En bref
🧩 La sauvegarde protège les données, mais elle ne garantit pas la reprise rapide d’un service. Sans restauration testée, elle reste une promesse fragile.
⏱️ Deux indicateurs structurent la décision : la tolérance à la perte de données et le délai de reprise. Ils doivent être définis par métier, pas seulement par l’informatique.
🔐 Une stratégie solide combine copies isolées, chiffrement des sauvegardes, protection contre l’altération et procédures documentées.
🧪 Le vrai révélateur reste le test de restauration. Une sauvegarde jamais restaurée n’a pas encore prouvé qu’elle protège l’activité.
Que recouvrent vraiment sauvegarde, restauration et continuité d’activité ?
La sauvegarde conserve une copie exploitable des données, la restauration remet ces données ou un service en état d’usage, tandis que la continuité d’activité organise la poursuite ou la reprise des opérations malgré un incident. Les confondre crée un faux confort : avoir une copie ne dit rien du délai de redémarrage, ni de la capacité réelle à travailler.
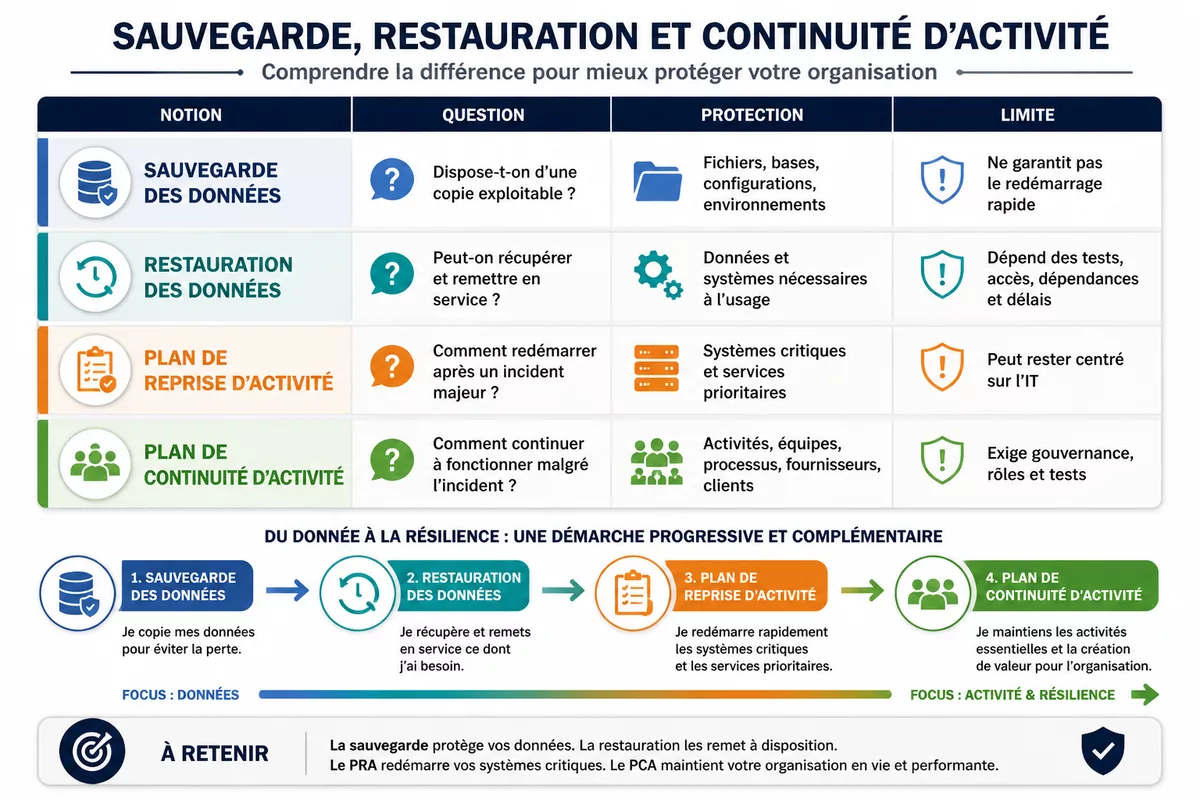
La sauvegarde des données répond d’abord à une question simple : existe-t-il une copie utilisable si la donnée d’origine disparaît, est corrompue ou devient inaccessible ? Cette copie peut concerner des fichiers, des bases de données, des machines virtuelles, des configurations applicatives, des messageries, des espaces collaboratifs ou des environnements cloud. Mais une copie n’est utile que si elle est complète, lisible, protégée et récupérable dans un contexte de crise.
La restauration des données ajoute une contrainte opérationnelle : combien de temps faut-il pour remettre les éléments en état de fonctionnement ? Restaurer un fichier supprimé par erreur n’a rien à voir avec reconstruire un serveur critique, relancer une application métier ou rétablir une chaîne de facturation. La restauration mobilise des accès, des priorités, des procédures, parfois des fournisseurs, et souvent des arbitrages.
La continuité d’activité va plus loin. Elle vise la capacité d’une organisation à poursuivre ses opérations pendant des pannes, des défaillances, des attaques ou des sinistres, éventuellement en mode dégradé. La CNIL rappelle, dans ses recommandations de sécurité, que la continuité et la reprise doivent être prévues avant l’incident, notamment lorsque des traitements de données personnelles sont impliqués.
Il faut aussi lever une ambiguïté fréquente : la “procédure de sauvegarde” peut désigner, en droit des entreprises en difficulté, un dispositif judiciaire destiné à une société qui n’est pas en cessation des paiements. Ce n’est pas le sujet principal ici. Dans cet article, “sauvegarde” désigne le backup informatique et son rôle dans la continuité opérationnelle.
| Notion | Question à laquelle elle répond | Ce qu’elle protège | Limite principale |
|---|---|---|---|
| Sauvegarde des données | Dispose-t-on d’une copie exploitable ? | Fichiers, bases, configurations, environnements | Ne garantit pas le redémarrage rapide |
| Restauration des données | Peut-on récupérer et remettre en service ? | Données et systèmes nécessaires à l’usage | Dépend des tests, accès, dépendances et délais |
| Plan de reprise d’activité | Comment redémarrer après un incident majeur ? | Systèmes critiques et services prioritaires | Peut rester centré sur l’IT sans couvrir toute l’organisation |
| Plan de continuité d’activité | Comment continuer à fonctionner malgré l’incident ? | Activités, équipes, processus, fournisseurs, clients | Exige une gouvernance, des rôles et des tests réguliers |
Pourquoi une sauvegarde ne suffit-elle pas à réduire l’interruption ?
Une sauvegarde ne réduit l’interruption que si elle peut être restaurée rapidement, dans le bon ordre, avec les bons droits et sur une infrastructure disponible. Le risque n’est pas seulement la perte de fichiers : c’est l’incapacité à reprendre une activité critique au moment où les équipes, les clients ou les partenaires attendent une réponse.
Un incident révèle toujours la différence entre promesse technique et réalité opérationnelle. Une entreprise peut avoir une sauvegarde quotidienne, mais découvrir que la dernière copie saine date d’avant une corruption silencieuse. Elle peut aussi disposer d’un stockage externe, mais ne plus avoir les identifiants, la documentation ou la capacité réseau nécessaire pour restaurer dans les délais.
Les causes sont variées. Une erreur humaine peut supprimer un dossier partagé. Une panne matérielle peut rendre un serveur inaccessible. Un sinistre local peut toucher les bureaux et les équipements. Un rançongiciel peut chiffrer les données de production et chercher à atteindre les sauvegardes connectées. Une mauvaise configuration cloud peut exposer ou effacer des éléments critiques.
Une sauvegarde jamais restaurée n’est pas une garantie : c’est une hypothèse technique qui n’a pas encore rencontré la crise.
Le coût réel du temps d’arrêt dépasse souvent le périmètre informatique. Il peut bloquer la facturation, retarder les livraisons, empêcher l’accès au support client, perturber la paie, ralentir la production ou créer une perte de confiance interne. Même sans chiffre universel, la logique est claire : plus un service est critique, plus le délai de reprise doit être court et mieux documenté.
C’est pourquoi une stratégie de sauvegarde continuité d’activité doit partir des usages. À quoi sert chaque système ? Qui en dépend ? Quelle activité s’arrête si ce service tombe ? Combien de données peut-on perdre sans rupture majeure ? Quelle procédure temporaire permet de continuer en mode dégradé ? La bonne réponse n’est pas “tout sauvegarder pareil”, mais hiérarchiser les risques.
- Données vitales : bases clients, commandes, comptabilité, contrats, configurations techniques, documents réglementaires.
- Services critiques : messagerie, ERP, CRM, outils de production, plateformes de vente, accès VPN, annuaires d’identité.
- Dépendances à vérifier : fournisseurs cloud, prestataires d’infogérance, liens réseau, licences, certificats, comptes administrateurs.
- Modes dégradés : procédures papier, accès restreint, priorisation clients, bascule vers un environnement secondaire.
Quels critères rendent une stratégie de sauvegarde continuité d’activité fiable ?
Une stratégie fiable combine fréquence adaptée, copies protégées, restauration testée, indicateurs de reprise et procédures lisibles. Le bon niveau dépend de la criticité métier : une donnée qui change toutes les minutes ne se protège pas comme une archive peu consultée, et un service client ne tolère pas le même arrêt qu’un espace documentaire secondaire.
Le premier critère est la fréquence. Sauvegarder une fois par jour peut suffire pour certaines données stables, mais être trop faible pour des transactions, commandes ou bases actives. La question n’est pas “quelle fréquence est moderne ?”, mais “combien de données peut-on perdre sans dommage sérieux ?”. Cette tolérance à la perte de données est parfois appelée RPO dans les démarches de reprise.
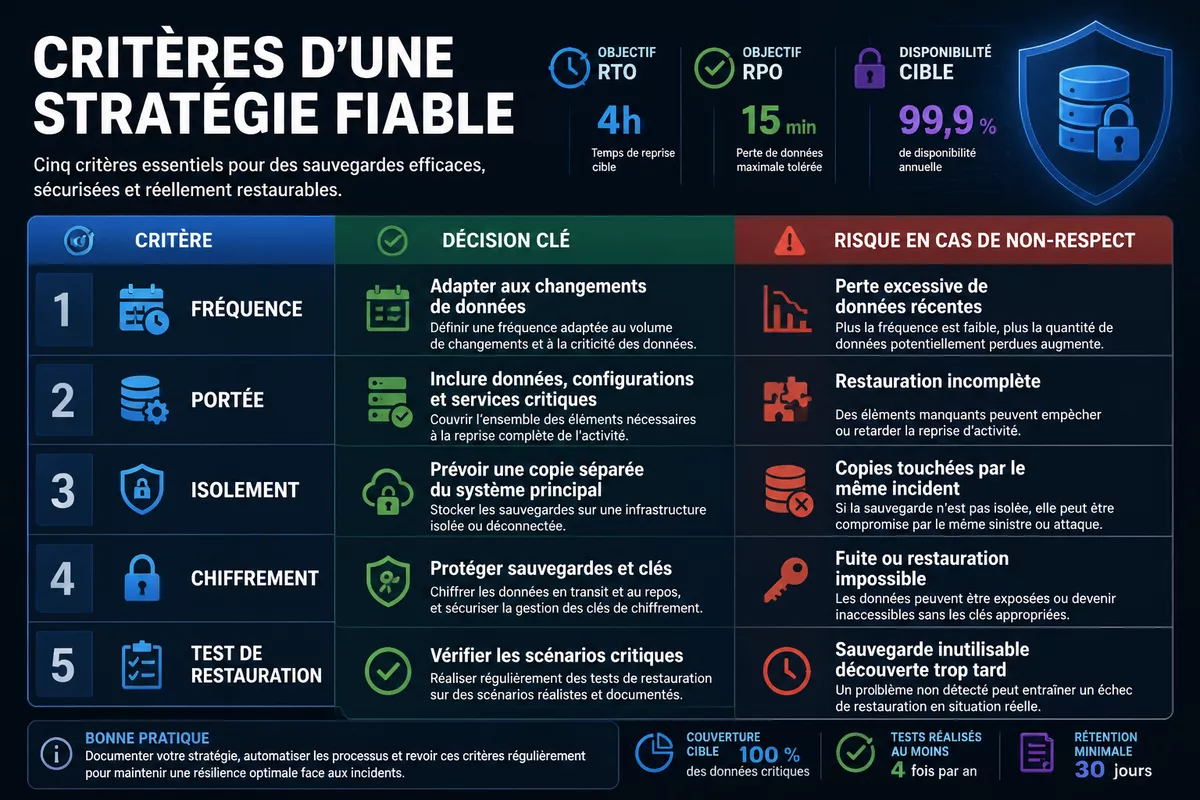
Le deuxième critère est la portée. Trop d’organisations protègent les fichiers visibles mais oublient les configurations, les bases applicatives, les journaux utiles à l’enquête, les documents hébergés dans des outils collaboratifs ou les paramètres d’authentification. Or, au moment de restaurer, ce sont souvent ces éléments périphériques qui ralentissent la reprise.
Le troisième critère est l’isolement. Une copie accessible en permanence depuis le système de production peut être pratique, mais elle peut aussi être supprimée, chiffrée ou altérée pendant l’incident. Les recommandations publiques en cybersécurité insistent sur la nécessité de protéger les sauvegardes contre l’accès non autorisé, la modification et la suppression. La logique dite stratégie 3-2-1 reste un repère utile : plusieurs copies, sur supports ou environnements distincts, avec au moins une copie séparée du système principal.
Le quatrième critère est le chiffrement des sauvegardes. Il protège la confidentialité si un support est perdu, compromis ou consulté par un acteur non autorisé. Mais il ajoute une exigence : les clés doivent être conservées, accessibles aux personnes habilitées et protégées contre la perte. Une sauvegarde chiffrée dont personne ne possède la clé au moment de la crise devient inutilisable.
Le cinquième critère est l’immutabilité ou, plus largement, la résistance à l’altération. L’idée est d’empêcher qu’une sauvegarde soit modifiée ou supprimée pendant une période définie. Ce n’est pas une baguette magique : une mauvaise configuration, des droits trop larges ou une durée de conservation incohérente peuvent affaiblir le dispositif. Mais face aux rançongiciels, c’est un levier majeur de réduction du risque.
| Critère | Décision à prendre | Risque si le critère est négligé | Vérification pratique |
|---|---|---|---|
| Fréquence | Adapter les sauvegardes à la vitesse de changement | Perte excessive de données récentes | Comparer la fréquence aux usages métier |
| Portée | Inclure données, configurations et services critiques | Restauration incomplète ou service inutilisable | Lister les dépendances par application |
| Isolement | Prévoir une copie séparée du système principal | Copies touchées par le même incident | Tester l’accès en scénario de crise |
| Chiffrement | Protéger les sauvegardes et les clés | Fuite de données ou restauration impossible | Contrôler droits, clés et procédures |
| Test de restauration | Vérifier régulièrement les scénarios critiques | Découverte tardive d’une sauvegarde inutilisable | Mesurer délai, erreurs et actions correctives |
Comment adapter le dispositif à la taille de l’organisation ?
La logique reste la même pour une TPE, une PME ou une grande organisation : identifier les activités critiques, protéger les données associées, tester la restauration et préparer la reprise. Ce qui change, c’est le niveau de formalisation, le nombre de dépendances, la charge de coordination et l’exigence de preuve.
Une petite structure n’a pas besoin d’un dispositif surdimensionné pour commencer. Elle doit d’abord identifier ce qui bloque réellement l’activité : ordinateur de gestion, logiciel de facturation, messagerie, documents clients, accès bancaires, base de production, site e-commerce. Ensuite, elle doit vérifier que ces éléments sont sauvegardés ailleurs que sur la seule machine utilisée au quotidien.
Dans une PME, le sujet devient plus transversal. Les données critiques sont souvent dispersées entre postes, serveurs, SaaS, outils comptables, messagerie, stockage partagé, applications métiers et prestataires. La sauvegarde continuité d’activité doit alors s’appuyer sur une cartographie simple : quelles équipes utilisent quel service, à quelle fréquence, avec quelle dépendance fournisseur et quelle priorité en cas d’incident ?
Dans une organisation plus grande, la difficulté se déplace vers la gouvernance. Il faut coordonner sécurité, infrastructure, métiers, direction, juridique, communication, fournisseurs et parfois assurance. Les exigences d’audit, de traçabilité et de conformité imposent une documentation plus robuste. La haute disponibilité peut réduire certaines interruptions du quotidien, mais elle ne remplace pas la récupération d’urgence face à une panne catastrophique ou une attaque massive.
- Classer les activités : distinguer les services vitaux, importants et secondaires.
- Associer les données : relier chaque activité aux fichiers, bases, outils et identifiants nécessaires.
- Définir la perte acceptable : préciser combien de données peuvent être perdues selon l’activité.
- Définir le délai de reprise : fixer une cible réaliste pour remettre le service en état.
- Tester un scénario : restaurer réellement un élément critique, mesurer le temps et documenter les écarts.
- Mettre à jour : réviser la procédure après changement d’outil, d’équipe, de fournisseur ou d’architecture.
L’arbitrage coût-robustesse doit rester lucide. Une solution sophistiquée, chère et rarement testée peut être moins fiable qu’un dispositif plus simple, compris par l’équipe et régulièrement vérifié. L’objectif n’est pas d’empiler des fonctions, mais de réduire deux risques : la perte irréversible de données et l’arrêt prolongé d’un service critique.
Quelles erreurs révèlent les incidents réels ?
Les incidents montrent rarement une absence totale de sauvegarde. Ils révèlent plutôt des angles morts : copies incomplètes, droits trop larges, restauration non testée, documentation introuvable, dépendance à une seule personne ou oubli des services hébergés. Le problème n’est pas toujours l’outil ; c’est souvent l’écart entre l’outil déployé et la réalité de l’activité.
La première erreur consiste à penser qu’un seul outil suffit. Un logiciel de sauvegarde peut automatiser les copies, mais il ne décide pas quelles activités sont prioritaires, qui valide une bascule, quel message envoyer aux clients, ni comment travailler si le système principal reste indisponible. La continuité d’activité relève autant de l’organisation que de l’infrastructure.
La deuxième erreur est de confondre stockage externe et sauvegarde robuste. Copier des fichiers dans un espace synchronisé peut faciliter le travail collaboratif, mais la synchronisation peut aussi propager une suppression ou une corruption. Une vraie politique de sauvegarde doit prévoir l’historique, la restauration, l’isolement, les droits, la conservation et la protection contre l’altération.
La troisième erreur est de négliger les données collaboratives. Beaucoup de données critiques ne résident plus sur un serveur interne : elles vivent dans des messageries, espaces partagés, outils SaaS, plateformes cloud ou applications métiers hébergées. La présence d’un fournisseur ne dispense pas de comprendre les responsabilités, les options de restauration, les limites contractuelles et les délais d’intervention.
La quatrième erreur est de ne jamais chronométrer la reprise. Le délai de reprise ne se devine pas. Il se mesure. Restaurer une base de test, vérifier l’intégrité, reconnecter une application, réattribuer les droits, relancer les traitements et informer les utilisateurs prennent du temps. Sans exercice, l’organisation découvre ces frictions au pire moment.
La continuité d’activité ne commence pas quand tout tombe : elle commence quand l’organisation accepte de tester ce qui la ferait redémarrer.
- Signal faible : personne ne sait quand le dernier test de restauration a eu lieu.
- Signal fort : les sauvegardes sont accessibles avec les mêmes comptes que la production.
- Signal critique : une seule personne détient les accès ou connaît la procédure.
- Signal organisationnel : les métiers n’ont jamais validé l’ordre de priorité des services.
- Signal cloud : les outils SaaS ne sont pas inclus dans l’inventaire des données critiques.
Comment passer d’une copie de fichiers à une vraie résilience ?
Le passage à la résilience repose sur trois réflexes : sauvegarder selon la criticité réelle, tester la restauration et préparer la continuité comme un sujet d’organisation. Il ne s’agit pas de tout rendre parfait, mais de réduire les surprises au moment de l’incident et de rendre les arbitrages explicites avant la crise.
La première action consiste à construire un inventaire priorisé. Il doit rester exploitable, pas bureaucratique. Pour chaque activité critique, il faut identifier les données, les applications, les comptes, les fournisseurs, les dépendances réseau et les personnes à contacter. Un tableau simple vaut mieux qu’un document ambitieux jamais relu.
La deuxième action est d’organiser des tests réalistes. Restaurer un fichier isolé ne suffit pas si le risque principal porte sur une base applicative ou un serveur complet. Il faut tester au moins les scénarios les plus critiques : suppression accidentelle, corruption, panne d’un serveur, indisponibilité d’un fournisseur, attaque par rançongiciel. Chaque test doit produire une trace : durée, difficultés, décisions, corrections à appliquer.
La troisième action est de relier la sauvegarde au plan de reprise d’activité et au plan de continuité d’activité. Le PRA vise la remise en service des systèmes après incident. Le PCA organise la poursuite de l’activité, éventuellement en mode dégradé. Les deux doivent dialoguer : un service restauré trop tard peut ne plus répondre au besoin métier, tandis qu’un mode dégradé sans données fiables peut produire des erreurs coûteuses.
| Situation | Risque principal | Réponse de sauvegarde | Réponse de continuité |
|---|---|---|---|
| Suppression accidentelle | Perte d’un fichier ou dossier récent | Versioning et restauration granulaire | Procédure de demande et validation rapide |
| Panne serveur | Service indisponible | Image système ou sauvegarde applicative | Priorité de reprise et environnement de secours |
| Rançongiciel | Données chiffrées et copies exposées | Copies isolées, immuables, contrôles d’intégrité | Cellule de crise, communication, reprise progressive |
| Sinistre local | Perte d’accès aux locaux ou équipements | Copie hors site et accès sécurisé | Télétravail, site alternatif, priorisation métier |
Le verdict est net : une stratégie de sauvegarde continuité d’activité crédible ne se juge pas à la quantité de données copiées, mais à la capacité démontrée de reprendre un service utile. Ce qui compte, c’est la chaîne complète : copie saine, accès maîtrisé, restauration validée, rôle de chacun connu et arbitrages métier assumés.
Sources utiles à consulter
Ces ressources permettent de vérifier les repères de sécurité, de continuité et de reprise sans dépendre d’un discours commercial. Elles ne remplacent pas une analyse de risque propre à l’organisation, mais elles donnent un socle fiable pour structurer les décisions.
| Source | Donnée utile | Usage concret | Vigilance |
|---|---|---|---|
| CNIL | Repères sur continuité et reprise d’activité | Préparer les traitements de données en cas d’incident | À adapter au contexte métier et aux données traitées |
| ANSSI / Cyber.gouv.fr | Bonnes pratiques cybersécurité et gestion d’incident | Renforcer sauvegardes, accès, protection contre rançongiciels | Vérifier les guides les plus récents selon votre secteur |
| Microsoft Learn | Distinction continuité, haute disponibilité et reprise après sinistre | Clarifier les concepts dans une architecture cloud ou hybride | Documentation orientée environnement Microsoft Azure |
| Service-Public Entreprendre | Sens juridique de la procédure de sauvegarde | Éviter la confusion entre sauvegarde informatique et sauvegarde judiciaire | Concerne les entreprises en difficulté, pas le backup informatique |
À retenir
- 🛡️ La sauvegarde conserve les données, mais seule la restauration prouve leur utilité réelle.
- ⏱️ Le délai de reprise et la perte acceptable doivent être fixés par activité critique.
- 🔐 Les copies isolées, chiffrées et protégées réduisent le risque de corruption ou d’effacement.
- 🧪 Un test de restauration régulier vaut mieux qu’un dispositif sophistiqué jamais vérifié.
- 📌 Le PCA et le PRA doivent couvrir équipes, fournisseurs, accès et modes dégradés.
FAQ
Quelle fréquence de sauvegarde faut-il choisir ?
Elle dépend de la vitesse à laquelle les données changent et de la perte acceptable en cas d’incident. Une base de commandes active peut nécessiter une fréquence plus élevée qu’un dossier d’archives. La bonne méthode consiste à classer les données par criticité avant de choisir la fréquence.
Faut-il tester chaque restauration ?
Il n’est pas toujours réaliste de tester chaque sauvegarde en détail, mais les scénarios critiques doivent être vérifiés régulièrement. Le test doit mesurer la durée, la qualité des données restaurées, les dépendances oubliées et les actions correctives à mener. Sans test, la sauvegarde reste une hypothèse.
Quelle différence entre plan de reprise d’activité et plan de continuité d’activité ?
Le plan de reprise d’activité vise à remettre les systèmes en service après un incident. Le plan de continuité d’activité organise la poursuite ou la reprise de l’activité dans son ensemble, y compris les équipes, les priorités, la communication et les modes dégradés.
Une petite structure doit-elle formaliser sa stratégie ?
Oui, même avec un document simple. Une petite organisation a souvent moins de marge pour absorber un arrêt prolongé, une perte de fichiers clients ou l’indisponibilité d’un outil de facturation. L’essentiel est d’identifier les données vitales, les accès, la copie hors site et la procédure de restauration.
La stratégie 3-2-1 suffit-elle contre un rançongiciel ?
Elle constitue un repère utile, mais elle ne suffit pas seule. Les sauvegardes doivent aussi être isolées, protégées contre la suppression, contrôlées, chiffrées et restaurables. Face à un rançongiciel, la gestion des accès et les tests de reprise comptent autant que le nombre de copies.