LLM ouvert ou propriétaire : comment choisir la meilleure base pour votre projet
Choisir entre un LLM ouvert ou propriétaire n’est pas un débat de principe. C’est un arbitrage de projet : niveau de contrôle, sensibilité des données, effort d’exploitation, vitesse de déploiement et coût total sur la durée. Un modèle ouvert gagne souvent quand il faut héberger, ajuster et gouverner soi-même. Un modèle propriétaire s’impose souvent quand il faut livrer vite avec peu d’infrastructure.
Le bon choix dépend donc moins de la promesse marketing que de la contrainte dominante. Si vous cherchez une base pour un assistant interne, un produit grand public, une chaîne de recherche documentaire ou un outil métier sensible, les critères ne pèsent pas pareil. L’objectif de cet article est simple : vous donner une grille de décision claire, avec les compromis réels, les cas où chaque option tient, et les erreurs qui coûtent cher.
En bref
⚖️ Le vrai critère n’est pas la “meilleure” IA, mais le meilleur compromis entre contrôle, délai et maintenance.
🔒 Un modèle ouvert devient plus pertinent quand la confidentialité, l’hébergement local et la personnalisation priment.
🚀 Un modèle propriétaire reste souvent plus simple pour prototyper vite et limiter la charge d’exploitation au départ.
💸 Le bon arbitrage se joue sur le coût total : usage, infrastructure, intégration, supervision, montée en charge et réversibilité.
Pourquoi le vrai sujet n’est-il pas la performance brute ?
La performance seule donne une mauvaise boussole. Deux modèles peuvent paraître proches sur un benchmark, puis diverger fortement dès qu’on ajoute la réalité du projet : données sensibles, RAG, latence, quota API, journalisation, contrôle qualité, ou obligation d’hébergement interne. Ce qui compte, c’est la performance utile dans votre contexte, pas le score le plus flatteur sur une démo.
Autrement dit, le bon arbitrage commence par le système autour du modèle : où il tourne, qui l’exploite, quels jeux de données il voit, comment il est mis à jour, et à quel rythme il doit évoluer. C’est là que le coût total et la réversibilité prennent souvent le dessus sur le simple coût d’accès.
Le bon arbitrage n’oppose pas un “meilleur” modèle à un “moins bon” modèle. Il oppose un niveau de contrôle à un niveau de simplicité.
| Critère | LLM ouvert | LLM propriétaire | Lecture pratique |
|---|---|---|---|
| Contrôle technique | Fort : hébergement, fine-tuning, gouvernance interne | Plus limité : dépend de l’éditeur et de ses API | Décisif si vous devez maîtriser l’inférence |
| Confidentialité | Meilleure maîtrise si l’infrastructure est interne | Variable selon les contrats et les paramètres de service | Crucial pour données sensibles ou réglementées |
| Vitesse de mise en production | Plus lente si l’équipe doit tout opérer | Souvent plus rapide grâce à une API prête à l’emploi | Fort avantage au propriétaire pour prototyper |
| Personnalisation | Plus poussée : ajustement fin, RAG, contraintes maison | Souvent plus encadrée | Important si le métier impose un comportement précis |
| Coût total | Peut baisser à volume stable, mais l’exploitation pèse | Variable, souvent simple au départ puis plus coûteux à grande échelle | À calculer sur 12 à 24 mois, pas au mois 1 |
| Dépendance fournisseur | Plus faible si la base est portable | Plus forte, surtout quand la logique métier repose sur l’API | Point sensible pour la réversibilité |
Ce que permet un modèle de langage ouvert
Un modèle de langage ouvert apporte d’abord du contrôle. Vous pouvez l’auto-héberger, le fine-tuner, le brancher à votre pile sécurité et décider de l’endroit où passent les données. Pour des usages internes, des secteurs régulés ou des produits qui doivent rester portables, c’est un avantage structurel. L’ouverture n’est pas un slogan : c’est une capacité d’industrialisation.
La nuance importante, pourtant, est juridique. “Ouvert” ne veut pas toujours dire “open source” au sens strict. Les open weights publient les poids du modèle, mais leur licence ne satisfait pas forcément la définition open source de l’OSI. Le dépôt open-llms sur GitHub illustre bien cette diversité : T5 y apparaît sous licence Apache 2.0, Dolly sous MIT, et Bloom sous OpenRAIL-M v1. Pour un usage commercial, il faut donc lire la licence avant de parler de liberté.
- Avantage clé : vous gardez la main sur l’inférence, les données et les règles d’exploitation.
- Avantage produit : vous pouvez ajuster le comportement au métier, au vocabulaire ou au contexte documentaire.
- Point d’attention : il faut une équipe capable d’opérer le modèle, de surveiller la qualité et de gérer les mises à jour.
- Point de vigilance : la licence compte autant que la performance affichée.
Un modèle ouvert n’est pas “gratuit” par défaut. Il déplace le coût : moins d’abonnement, plus d’infrastructure, plus d’intégration, plus d’exploitation.
Le cas français va dans la même direction. OpenLLM France met en avant la collecte et le traitement de données en français, la redistribution de données sous format ouvert et le partage des poids sous licence ouverte. La structure dit aussi quelque chose de la maturité du sujet : avec 9 partenaires officiels et 12 associés, financés par la BPI depuis septembre 2024 pour deux ans, l’enjeu n’est plus seulement la recherche. Il est aussi industriel et souverain.
Ce que change un modèle propriétaire
Un modèle propriétaire offre surtout une chose : aller vite sans porter toute l’usine autour. Vous branchez une API, vous testez, vous itérez, et vous obtenez assez souvent un niveau de qualité immédiatement exploitable. Pour un prototype, une équipe produit légère ou un service qui veut valider une valeur d’usage avant d’investir, c’est souvent le chemin le plus court.
La limite est connue : vous contrôlez moins la mécanique. L’évolution du service, les règles d’usage, la tarification, les quotas, la résidence des données ou les options avancées dépendent d’un fournisseur. Sur un faible volume, cette simplicité peut être rationnelle. À mesure que l’usage grandit, la facture et la dépendance peuvent devenir les vrais sujets.
- Avantage clé : une mise en production rapide avec peu de charge initiale.
- Avantage opérationnel : moins de supervision d’infrastructure et moins de travail de MCO.
- Point faible : personnalisation souvent plus encadrée que sur une base ouverte.
- Point faible : la réversibilité est plus difficile si tout le flux métier dépend d’une seule API.
Dans le répertoire open-llms, la logique est d’ailleurs parlante par contraste : une sélection de modèles ouverts ou exploitables commercialement permet de sortir du tout-éditeur, mais demande de lire la licence et de vérifier le cadre d’usage. Le propriétaire simplifie l’entrée, pas nécessairement la sortie.
Quels critères faut-il examiner avant de trancher ?
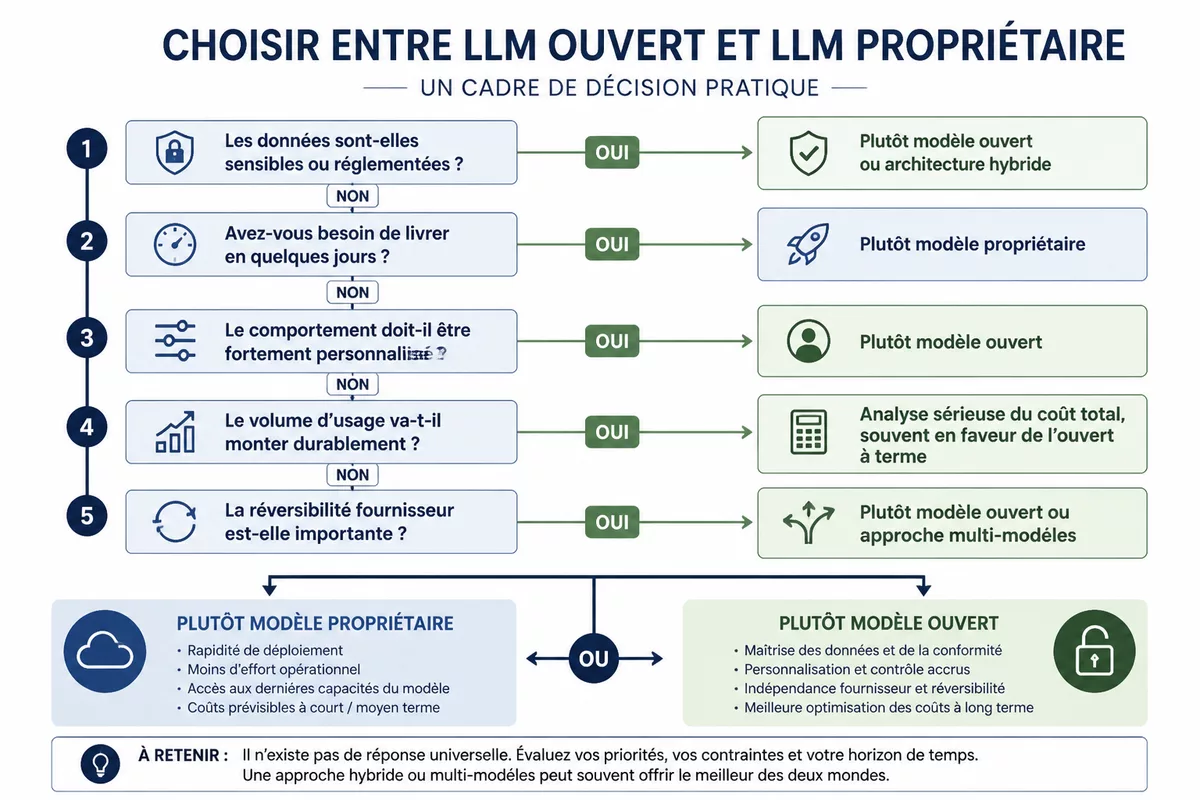
Le choix devient plus net quand on passe d’une question générale à une grille concrète. Si votre projet traite des données sensibles, vise une intégration métier profonde ou doit rester portable dans deux ans, le modèle ouvert prend de la valeur. Si vous devez livrer vite avec une petite équipe et un périmètre encore mouvant, le propriétaire reste souvent plus efficace au départ.
| Question de décision | Si la réponse est plutôt oui | Orientation probable |
|---|---|---|
| Les données sont-elles sensibles ou réglementées ? | Oui, avec exigence d’hébergement maîtrisé | Plutôt modèle ouvert ou architecture hybride |
| Avez-vous besoin de livrer en quelques jours ? | Oui, avec peu de dette d’infrastructure | Plutôt modèle propriétaire |
| Le comportement doit-il être fortement personnalisé ? | Oui, avec règles métier et garde-fous précis | Plutôt modèle ouvert |
| Le volume d’usage va-t-il monter durablement ? | Oui, avec coûts récurrents à surveiller | Analyse sérieuse du coût total, souvent en faveur de l’ouvert à terme |
| La réversibilité fournisseur est-elle importante ? | Oui, pour éviter l’enfermement technique | Plutôt modèle ouvert ou approche multi-modèles |
- Budget réel : additionnez usage, GPU ou cloud, intégration, support, supervision et reprise en main.
- Données : mesurez ce qui peut sortir du périmètre et ce qui doit rester interne.
- Personnalisation : distinguez RAG, règles métier et ajustement fin, car les besoins ne sont pas les mêmes.
- Exploitation : vérifiez qui surveille la latence, les erreurs, les dérives et les mises à jour.
- Réversibilité : demandez-vous ce qu’il faudra reconstruire si le fournisseur ou le modèle change.
Exemple indicatif : si une équipe dépense l’équivalent de 8 000 € par mois en API propriétaire pour un usage stable, puis 4 000 € d’infrastructure et 2 000 € d’exploitation pour une base ouverte, le second scénario devient plus attractif à volume constant. Mais la comparaison n’est valable que si le niveau de qualité, le délai de livraison et la charge humaine restent tenables. C’est là que le coût total change de camp.
Quel choix selon la contrainte dominante du projet ?
La réponse courte est simple : open quand le contrôle, la confidentialité et la personnalisation dominent ; propriétaire quand la vitesse de mise en production et la simplicité d’exploitation dominent. Le bon choix n’est donc pas le même pour un assistant interne, un prototype grand public, un moteur documentaire ou un produit critique.
Assistant interne et données sensibles
Ici, le contrôle pèse lourd. Si l’assistant accède à des documents RH, juridiques, financiers ou techniques, la question n’est pas seulement la qualité de génération. Elle porte aussi sur la résidence des données, la journalisation, la politique d’accès et la capacité à garder la main sur les flux. Dans ce cas, un modèle ouvert, parfois couplé à de la génération augmentée par recherche, devient souvent plus défendable.
Produit grand public ou prototype rapide
Quand il faut tester une hypothèse produit, la priorité est souvent d’apprendre vite. Un modèle propriétaire permet de valider l’usage sans construire trop tôt toute la couche d’exploitation. Le risque, c’est de confondre vitesse de démo et architecture durable. Si le prototype réussit, il faut alors reposer la question du coût total et de la dépendance.
Recherche documentaire et automatisation métier
Pour un système de recherche, d’extraction ou de réponse assistée, le choix n’est pas forcément exclusif. Le modèle propriétaire peut servir à démarrer ; la base ouverte peut reprendre le relais quand la gouvernance devient critique. Dans beaucoup de projets, l’architecture la plus rationnelle est hybride : un moteur de recherche ou de récupération documentaire solide, puis un LLM placé au-dessus.
Les sélectionneurs de modèles orientés production vont dans ce sens. Une revue de 2026 chez Fireworks compare 7 modèles ouverts et les met à disposition pour une inférence serverless immédiate. Ce type d’approche montre une chose utile : le marché ne se résume plus à “open” ou “fermé”, mais à la capacité de brancher rapidement un modèle au bon niveau d’exploitation. C’est précisément là que le projet gagne ou perd du temps.
Faut-il vraiment opposer les deux approches ?
Pas toujours. Dans la pratique, les scénarios hybrides sont souvent les plus rationnels. On lance parfois avec un modèle propriétaire pour aller vite, puis on migre tout ou partie vers une base ouverte dès que le volume, la sensibilité des données ou la facture justifient de reprendre la main. L’opposition binaire est rassurante, mais elle décrit mal les trajectoires réelles des produits.
Le point clé est de ne pas subir l’architecture par défaut. Si vous partez propriétaire, prévoyez dès le début ce qui doit rester portable : schéma des prompts, couche d’orchestration, base documentaire, tests de non-régression, métriques qualité. Si vous partez ouvert, prévoyez ce qui coûte réellement : MCO, monitoring, sécurité, mises à jour, gestion des versions et montée en charge.
Le verrouillage ne vient pas seulement du modèle. Il vient surtout de tout ce que vous construisez autour sans prévoir de sortie.
Sources utiles à consulter
Pour consolider votre arbitrage, mieux vaut croiser la licence, la documentation du modèle et la politique d’usage du fournisseur. Voici les sources les plus utiles pour avancer sans confondre marketing et cadre réel.
| Source | Donnée utile | Usage concret | Vigilance |
|---|---|---|---|
| Open Source Initiative | Définition de l’open source | Vérifier si un modèle “ouvert” est aussi open source au sens strict | Ne pas confondre poids publiés et licence réellement libre |
| open-llms sur GitHub | Liste de modèles et licences | Repérer les modèles utilisables commercialement | Lire la licence au cas par cas, pas seulement le nom du modèle |
| OpenLLM France | Données, poids, logique de souveraineté | Comprendre un écosystème francophone orienté transparence | Vérifier la maturité d’usage selon votre cas réel |
| Documentation du fournisseur propriétaire | Quota, prix, résidence des données, clauses d’usage | Mesurer le coût total et la réversibilité | Les conditions changent, donc la date de lecture compte |
À retenir
- ⚙️ Un LLM ouvert convient surtout quand le contrôle et la portabilité priment.
- 🔐 Un modèle propriétaire convient souvent quand la vitesse d’exécution compte d’abord.
- 🧮 Le bon arbitrage se joue sur le coût total, pas sur le tarif d’entrée seul.
- 🧩 La licence, l’hébergement et l’exploitation comptent autant que la qualité brute.
- ↔️ Le meilleur choix est souvent hybride si le projet doit évoluer sans verrouillage.
FAQ
Un modèle ouvert est-il toujours plus économique ?
Non. Il peut devenir plus intéressant à volume stable, mais il ajoute des coûts d’infrastructure, de maintenance et de supervision. Sur un petit projet ou un prototype court, un modèle propriétaire peut rester moins cher et plus rationnel.
Un modèle propriétaire est-il forcément plus performant ?
Non. Il est souvent plus simple à utiliser et parfois excellent en sortie de boîte, mais la performance réelle dépend du cas d’usage, du contexte métier et du niveau de personnalisation attendu. Le meilleur score brut ne garantit pas la meilleure solution.
Peut-on combiner les deux approches dans un même projet ?
Oui, et c’est souvent la meilleure voie. Beaucoup d’équipes démarrent avec un modèle propriétaire pour valider le besoin, puis migrent vers un modèle ouvert pour gagner en contrôle, en réversibilité ou en confidentialité.
Quel choix privilégier pour des données sensibles ?
Si la donnée est sensible, la priorité va au contrôle de l’hébergement, à la gouvernance et à la traçabilité. Cela oriente souvent vers un modèle ouvert ou une architecture hybride, à condition de pouvoir opérer correctement la solution.
Faut-il choisir un modèle ouvert dès le premier jour ?
Pas forcément. Si votre priorité est de tester vite une valeur d’usage, le propriétaire peut être un bon point de départ. L’important est d’anticiper la sortie : architecture portable, base documentaire maîtrisée et métriques qualité réutilisables.